Was „KI-ready Daten“ wirklich bedeuten: eine Checkliste mit 7 Punkten
„KI-ready“ steht auf jeder Folie der Anbieter, und fast niemand sagt, was es heißt. Hier eine konkrete, messbare Definition: sieben Prüfpunkte, die entscheiden, ob eine KI einen Datensatz wirklich finden, ihm trauen und ihn richtig nutzen kann, und wie Sie jeden davon bewerten.
Warum „KI-ready Daten“ eine echte Definition brauchen
„KI-ready Daten“ stehen auf jeder Folie der Anbieter und in jeder Vorstandspräsentation, und fast niemand sagt, was damit gemeint ist. Locker gebraucht sagt es nichts: Jeder Datensatz ist „KI-ready“, wenn man die Augen zusammenkneift. Genau gebraucht ist es einer der nützlichsten Filter, die ein Datenteam hat: eine konkrete Hürde, die ein Datensatz nimmt oder nicht, und eine Liste genau dessen, was zu beheben ist, wenn er sie nicht nimmt.
Dieser Beitrag ist die praktische Fassung. Den begrifflichen Boden lassen wir aus: Für die Definition selbst siehe den Eintrag im Glossar zu KI-ready Daten, und für die Disziplin, Kontext zusammenzustellen, unseren Leitfaden zum Context Engineering für KI im Unternehmen. Hier folgt stattdessen eine Checkliste: sieben Prüfpunkte, die aus einem vagen Anspruch etwas machen, das Sie Datensatz für Datensatz bewerten können.
Eine Arbeitsdefinition: finden, vertrauen, nutzen
Streicht man das Marketing weg, ist die Anforderung einfach. Daten sind KI-ready, wenn eine KI sie finden, ihnen trauen und sie richtig nutzen kann, ohne dass ein Mensch den fehlenden Kontext nachliefert. Jedes dieser drei Verben ist die Stelle, an der die meisten Daten scheitern.
Eine KI kann Daten nicht finden, die sie nicht entdecken kann oder deren Bedeutung nicht dokumentiert ist. Sie kann Daten nicht trauen, deren Herkunft, Qualität, Sensibilität und Verantwortung unbekannt sind. Und sie kann Daten nicht nutzen, die kein Werkzeug wirklich lesen kann. KI-ready ist der Zustand, in dem alle drei gelten, und die sieben Prüfpunkte unten sind schlicht diese drei Verben, konkret und messbar gemacht.
„KI-ready ist keine Eigenschaft Ihres Modells. Es ist eine Eigenschaft Ihrer Daten.“
Die Checkliste für KI-ready Daten
Hier sind die sieben Prüfpunkte. Der erste macht Daten auffindbar, die mittleren fünf machen sie vertrauenswürdig, der letzte macht sie für KI-Werkzeuge nutzbar. Keiner ist verzichtbar bei Daten, auf denen eine KI handeln wird, denn die KI ist nur so verlässlich wie ihr schwächster Punkt: Eine perfekte Definition speist immer noch eine falsche Antwort, wenn die Daten dahinter aus einer defekten Pipeline kamen.
Punkt 1. Katalogisiert: die KI kann sie finden
Eine KI kann Daten nicht nutzen, die sie nicht entdecken kann. Der erste Prüfpunkt ist, ob der Datensatz in einem Datenkatalog liegt, einem durchsuchbaren Verzeichnis dessen, was es über Ihre Warehouses, Lakehouses, BI-Werkzeuge und operativen Systeme hinweg gibt, samt den Metadaten, die jeden Bestand auffindbar machen. Daten, die ohne Katalogeintrag über Systeme verstreut sind, sind für KI unsichtbar, was heißt, dass die KI sie entweder übergeht oder, schlimmer, nach einer schlechteren Quelle greift, die sie sehen kann.
So messen Sie es: Lässt sich ein bestimmter Datensatz über ein Stichwort oder einen Geschäftsbegriff im Katalog finden, samt Ort, Schema und grundlegenden Metadaten? Hängt das Entdecken weiterhin daran, eine bestimmte Person zu fragen, ist dieser Punkt nicht erfüllt.
Punkt 2. Definiert: sie weiß, was die Felder bedeuten
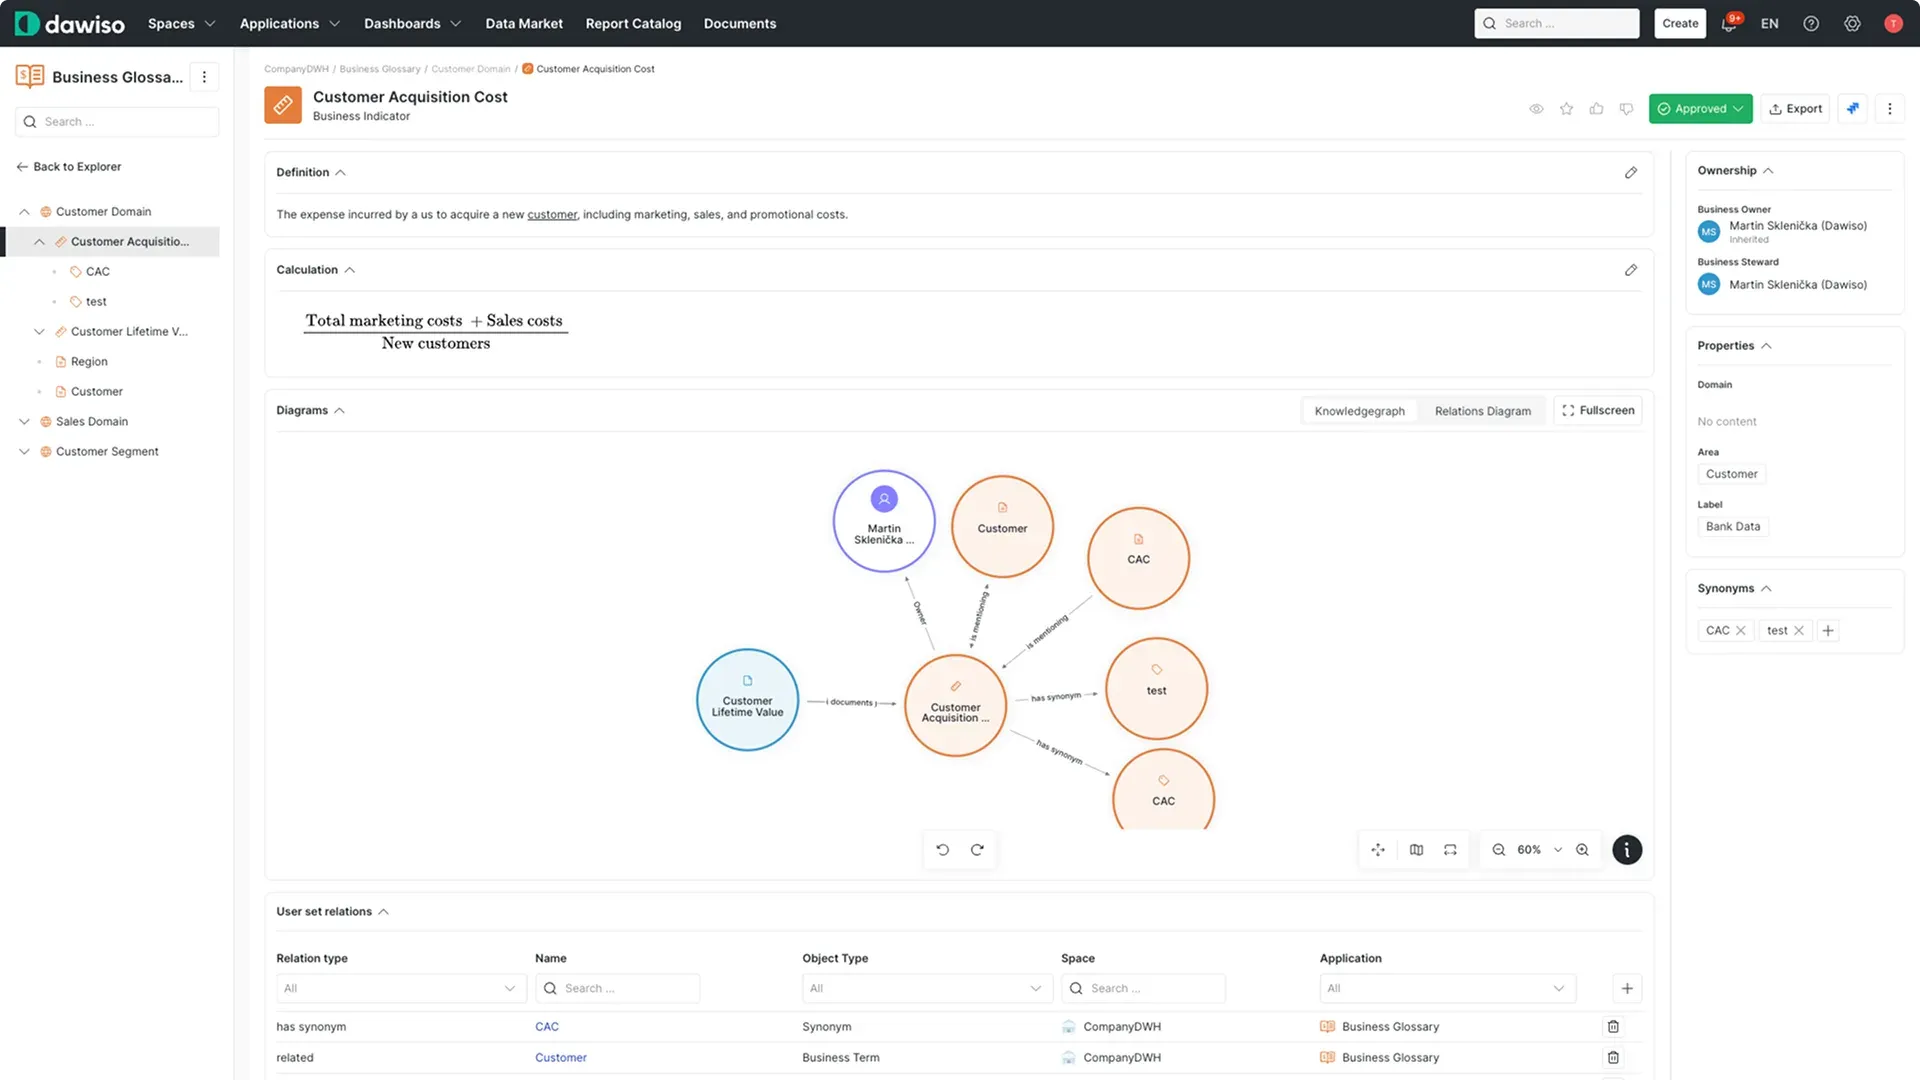
Eine Tabelle zu finden heißt nicht, sie zu verstehen. Der zweite Prüfpunkt ist, ob die fachliche Bedeutung der Daten in einem Business Glossary dokumentiert ist: was jede Kennzahl und jede Entität bedeutet, wie sie berechnet wird und welche Sonderfälle Menschen stolpern lassen. Eine Spalte namens rev ist bedeutungslos, bis irgendwo festgehalten ist, dass sie netto nach Erstattungen, in Berichtswährung und realisiert statt gebucht ist. Das ist der Prüfpunkt mit der größten Hebelwirkung, denn undefinierte Daten sind genau das, was eine KI raten lässt, und die Bedeutung zu raten ist der Grund, warum Text-to-SQL im Unternehmen scheitert.
So messen Sie es: Haben die wichtigsten Kennzahlen und Entitäten im Datensatz freigegebene, von Verantwortlichen verfasste Definitionen, die mit den zugrunde liegenden Spalten verknüpft sind? Lebt die Bedeutung nur im Kopfwissen oder in einem veralteten Wiki, ist dieser Punkt nicht erfüllt.
Punkt 3. Klassifiziert: sie weiß, was sensibel ist
Bevor eine KI Daten nutzt, muss sie wissen, was sie damit tun darf. Der dritte Prüfpunkt ist die Klassifizierung: welche Felder personenbezogene Daten, Finanzdaten oder andere sensible Angaben enthalten und welche Richtlinie ihre Nutzung regelt. Ohne sie zeigt ein fähiger Assistent eine Gehaltstabelle oder die persönlichen Angaben einer Kundin jedem, der die richtige Frage stellt, weil ihm nichts gesagt hat, dass die Daten beschränkt sind.
So messen Sie es: Sind sensible Felder mit einer Klassifizierung und einer Zugriffsrichtlinie versehen, die mit den Daten mitwandert? Könnte ein KI-Werkzeug regulierte Daten allein deshalb offenlegen, weil sie erreichbar sind, ist dieser Punkt nicht erfüllt.
Punkt 4. Lineage nachvollziehbar: Antworten sind belastbar und prüfbar
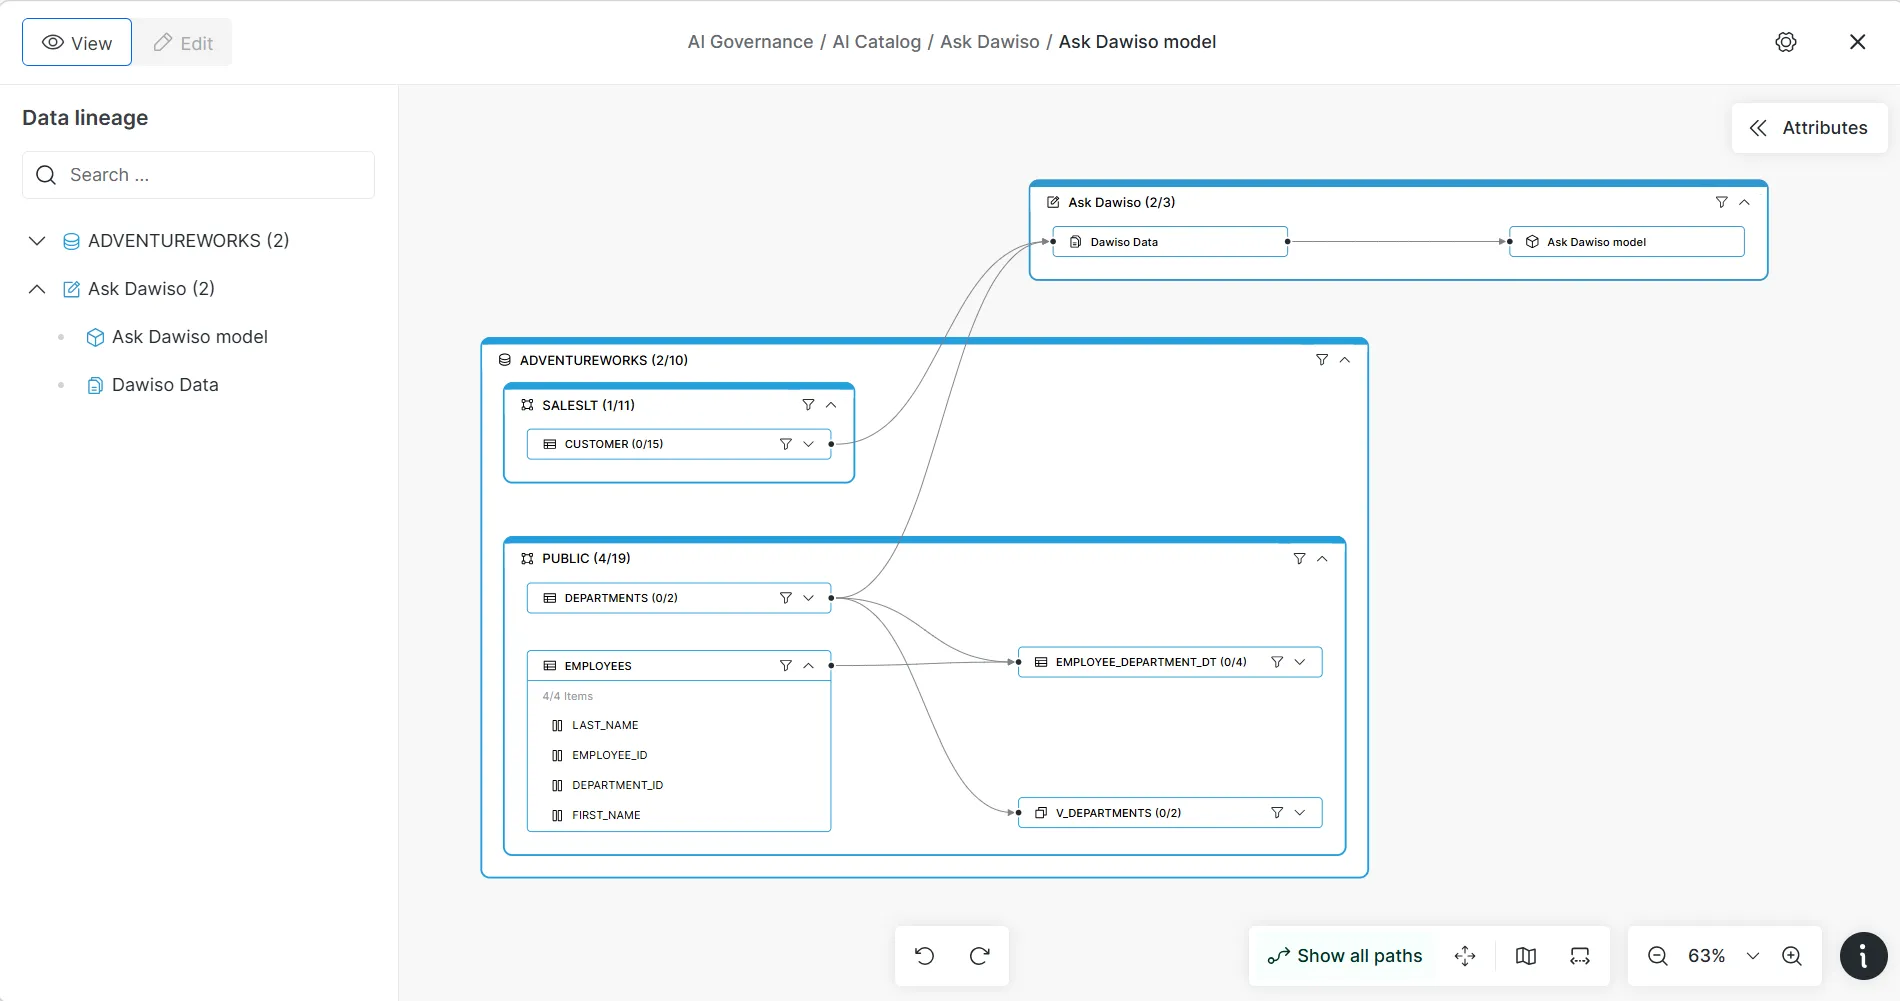
Der vierte Prüfpunkt ist die Lineage: eine nachvollziehbare Karte, woher die Daten kamen, was sie umgeformt hat und was von ihnen abhängt. Lineage ist das, was eine Antwort der KI auf eine Quelle zurückführen lässt und was Ihnen zeigt, bevor ein Problem das Modell erreicht, dass eine Definition von einer Pipeline gespeist wird, die über Nacht ausgefallen ist. In der Zeit der Agenten ist das keine Annehmlichkeit: Ein Agent, der auf einer nicht nachvollziehbaren Zahl handelt, ist ein Risiko für Betrieb und Compliance, nicht nur ein falsches Dashboard.
So messen Sie es: Können Sie jeden Wert, den die KI zurückgibt, durch seine Umformungen hindurch auf eine maßgebliche Quelle zurückverfolgen? Lautet die Antwort „vermutlich, wenn jemand den Pipeline-Code liest“, ist dieser Punkt nicht erfüllt.
Punkt 5. Qualität bewertet: die Daten sind gut genug zum Handeln
Eine KI auf schlechten Daten erzeugt flüssige, selbstbewusste, falsche Antworten schneller, als ein Mensch es könnte. Der fünfte Prüfpunkt ist, ob der Datensatz gemessene Qualitätssignale über die Dimensionen trägt, die zählen (Genauigkeit, Vollständigkeit, Einheitlichkeit, Aktualität), idealerweise an einem anerkannten Modell wie ISO/IEC 25012, dazu einen klaren Stand zwischen zertifiziert und abgekündigt. Qualität ist das, was eine maßgebliche Quelle von einer veralteten Kopie trennt, und die KI kann die beiden von sich aus nicht unterscheiden.
So messen Sie es: Gibt der Datensatz Aktualität, Vollständigkeit und einen Zertifizierungsstand preis, die die KI (und ein Mensch) prüfen kann? Lässt sich „sind diese Daten gut?“ nur aus dem Bauch beantworten, ist dieser Punkt nicht erfüllt.
Punkt 6. Verantwortet: jemand steht dafür ein
Kontext ohne Verantwortung verfällt. Der sechste Prüfpunkt ist, ob der Datensatz eine benannte verantwortliche Person und einen Steward hat: jemanden, der für seine Definitionen, seine Qualität und seine Zugriffsregeln einsteht. Verantwortung ist das, was die anderen sechs Punkte wahr hält, während sich das Geschäft ändert: Wenn eine Definition angepasst werden muss oder sich eine Pipeline ändert, gibt es eine Person statt eines diffusen „das sollte mal jemand richten“. Daten ohne Verantwortung driften von der Wirklichkeit weg, und eine KI traut ihnen noch lange, nachdem sie aufgehört haben zu stimmen.
So messen Sie es: Können Sie die verantwortliche Person und den Steward des Datensatzes benennen, und gibt es einen Freigabeablauf für Änderungen an seinen Definitionen und Richtlinien? Lautet die Verantwortung „das Datenteam, gemeinsam“, ist dieser Punkt nicht erfüllt.
Punkt 7. Über MCP erreichbar: die KI kann sie wirklich lesen
Die ersten sechs Punkte regeln den Kontext. Der siebte liefert ihn aus. All diese Bedeutung, Klassifizierung, Lineage und Verantwortung nützen einer KI nichts, wenn sie in den Werkzeugen eingeschlossen bleiben, die sie halten. Der letzte Prüfpunkt ist, ob Ihr geregelter Kontext über einen standardisierten, offenen Kanal bereitsteht: das Model Context Protocol (MCP), sodass jeder kompatible Assistent und jeder Agent ihn bei Bedarf lesen kann. Über einen MCP Server werden Ihr Katalog, Ihr Glossar, Ihre Klassifizierung und Ihre Lineage zu einem einzigen Endpunkt, den jedes KI-Werkzeug abfragen kann.
So messen Sie es: Kann sich ein neues KI-Werkzeug einmal verbinden und Ihre geregelten Definitionen, Richtlinien und Lineage lesen, oder muss jedes Werkzeug sie intern neu bauen? Kann Ihr Kontext das Werkzeug nicht verlassen, das ihn gebaut hat, ist dieser Punkt nicht erfüllt, und Sie bauen Silos neu, ein Assistent nach dem anderen.
So bewerten Sie Ihre Bereitschaft
Die Checkliste nützt nur, wenn Sie sie anwenden. Bewerten Sie für jeden Datensatz, den eine KI nutzen wird, jeden Punkt als vorhanden, teilweise oder fehlt. Ein Datensatz ist nur dann KI-ready, wenn alle sieben vorhanden sind; jedes „fehlt“ ist ein blinder Fleck, an dem die KI aufs Raten zurückfällt, und jedes „teilweise“ ist ein stilles Risiko. Die meisten Teams finden ihre Daten um die ersten beiden Punkte herum versammelt (etwas Katalog, lückenhafte Definitionen) und dünner werdend Richtung Klassifizierung, Lineage und Bereitstellung, was zugleich die Reihenfolge ist, in der die Fehler teuer werden.
Nutzen Sie den Bewertungsbogen unten als Vorlage. Führen Sie ihn je Bereich, statt alles auf einmal anzugehen: Bringen Sie eine Handvoll wertvoller Datensätze auf alle sieben, bevor Sie das Netz weiter spannen. Bereitschaft ist keine einmalige Note; bewerten Sie neu, wenn sich Daten und Definitionen ändern, denn ein Datensatz, der im letzten Quartal KI-ready war, driftet in dem Moment ab, in dem seine Bedeutung oder seine Qualität es tut.
Mit Dawiso KI-ready werden
Der Grund, warum „KI-ready“ vage wirkt, ist, dass die sieben Punkte meist an sieben verschiedenen Orten liegen, falls es sie überhaupt gibt. Dawiso fügt sie über mehr als 40 Plattformen hinweg in einer geregelten Schicht zusammen: einen Data Catalog (katalogisiert), ein Business Glossary (definiert), Klassifizierung und Richtlinie (klassifiziert), Interactive Lineage (Lineage nachvollziehbar), Signale zu Qualität und Zertifizierung (Qualität bewertet) und Verantwortung mit Abläufen für Stewardship (verantwortet). Dawiso AI entwirft Beschreibungen und Klassifizierung zur menschlichen Prüfung, sodass das Schließen der Lücken Konfiguration ist und kein Bauvorhaben über mehrere Quartale.
Der siebte Punkt ist das, was alles zusammenbindet. Über den Context Layer und seinen MCP Server wird dieser geregelte Kontext jedem MCP-fähigen Assistenten und jedem Agenten bereitgestellt, sodass Ihre Daten für jedes Werkzeug auf einmal KI-ready sind statt für eine Anbindung nach der anderen. Wenn Sie den Aufbau Schritt für Schritt wollen, behandelt unser begleitender Leitfaden, wie Sie einen Context Layer für KI im Unternehmen umsetzen. KI-ready Daten sind kein Slogan und keine Eigenschaft Ihres Modells. Sie sind sieben Eigenschaften Ihrer Daten, und es sind Eigenschaften, die Sie regeln können.
FAQ
Was heißt „KI-ready Daten“ eigentlich?
Woran erkenne ich, ob meine Daten KI-ready sind?
Was ist der Unterschied zwischen KI-ready Daten und guter Datenqualität?
Brauche ich alle sieben Punkte, oder sind manche verzichtbar?
Wie macht Dawiso Daten KI-ready?
In Aktion erleben
Dawiso Context Layer
Machen Sie Ihre Daten einmal KI-ready: katalogisiert, definiert, geregelt, und stellen Sie sie dann jedem KI-Werkzeug über MCP bereit.