Warum 95 % der GenAI-Pilotprojekte scheitern: die verborgene Datenkrise hinter KI
Unternehmen investieren Milliarden in KI, doch fast alle Pilotprojekte im Unternehmen bleiben schon am Start stehen. Laut „The GenAI Divide: State of AI in Business 2025“, einem neuen Bericht der NANDA-Initiative des MIT, birgt generative KI erhebliches Potenzial für Unternehmen. Die meisten Vorhaben, die rasches Umsatzwachstum bringen sollen, liefern jedoch nicht die erwarteten Ergebnisse.
MIT-Bericht: 95 % der Pilotprojekte mit generativer KI in Unternehmen scheitern
Eine neue Studie des MIT macht überall Schlagzeilen, aus gutem Grund. Sie zeigt, dass 95 % der Pilotprojekte mit generativer KI im Unternehmen nie über die Pilotphase hinauskommen und Unternehmen mit versenkten Kosten und kaum messbarer Wirkung zurücklassen. Das ist besonders auffällig angesichts der bereits investierten Milliarden: Unternehmen haben schätzungsweise 30 bis 40 Mrd. $ in generative KI gesteckt, und doch schaffen nur etwa 5 % der Vorhaben echten Wert.
Die Untersuchung, die auf 150 Gesprächen mit Führungskräften, einer Befragung von 350 Beschäftigten und einer Auswertung von 300 öffentlichen KI-Einsätzen beruht, zeigt eine scharfe Kluft zwischen den Erwartungen und der Wirklichkeit. Auf der einen Seite stehen die wenigen Unternehmen, die umwälzende Ergebnisse erzielen und mit gezielten Anwendungen im Kundendienst, in der kreativen Produktion oder im Risikomanagement jährlich Millionen sparen. Auf der anderen Seite bleibt die große Mehrheit stecken und kommt über Versuche oder Anwendungsfälle mit geringem Wert nicht hinaus.
Warum also stockt KI im Unternehmen? Laut MIT liegt es nicht an Infrastruktur, Budget oder auch nur Talent. Die eigentliche Hürde ist das Lernen. Die meisten KI-Einsätze scheitern, weil sie sich nicht anpassen können: Die Systeme behalten keine Rückmeldungen, ordnen nichts in den Kontext ein und werden über die Zeit nicht besser. Zusammen mit einer wachsenden Welle von „Schatten-KI“, bei der Beschäftigte die Werkzeuge des Unternehmens umgehen und zu Anwendungen wie ChatGPT oder Claude greifen, ergibt das ein Bild von Unternehmen, die mit der Technik, in die sie investiert haben, nicht Schritt halten.
Diese Kluft, die das MIT GenAI Divide nennt, wird rasch zu einer der bestimmenden Aufgaben für Unternehmen im Jahr 2025. Die Frage ist nun, was die Gewinner vom Rest trennt und wie Unternehmen die Lücke schließen, bevor die Investitionen in KI nur eine weitere versenkte Ausgabe werden.
Die Hürden, die Unternehmen festhalten
Die größten Hürden spiegeln die grundlegende Lernlücke, die das GenAI Divide ausmacht: Nutzer wehren sich gegen Werkzeuge, die sich nicht anpassen, die Qualität der Modelle bricht ohne passenden Kontext ein, und die Bedienung leidet, wenn Systeme das Wissen des Unternehmens nicht behalten können. Selbst eifrige Nutzer von ChatGPT misstrauen internen GenAI-Werkzeugen, die ihren Erwartungen nicht entsprechen.
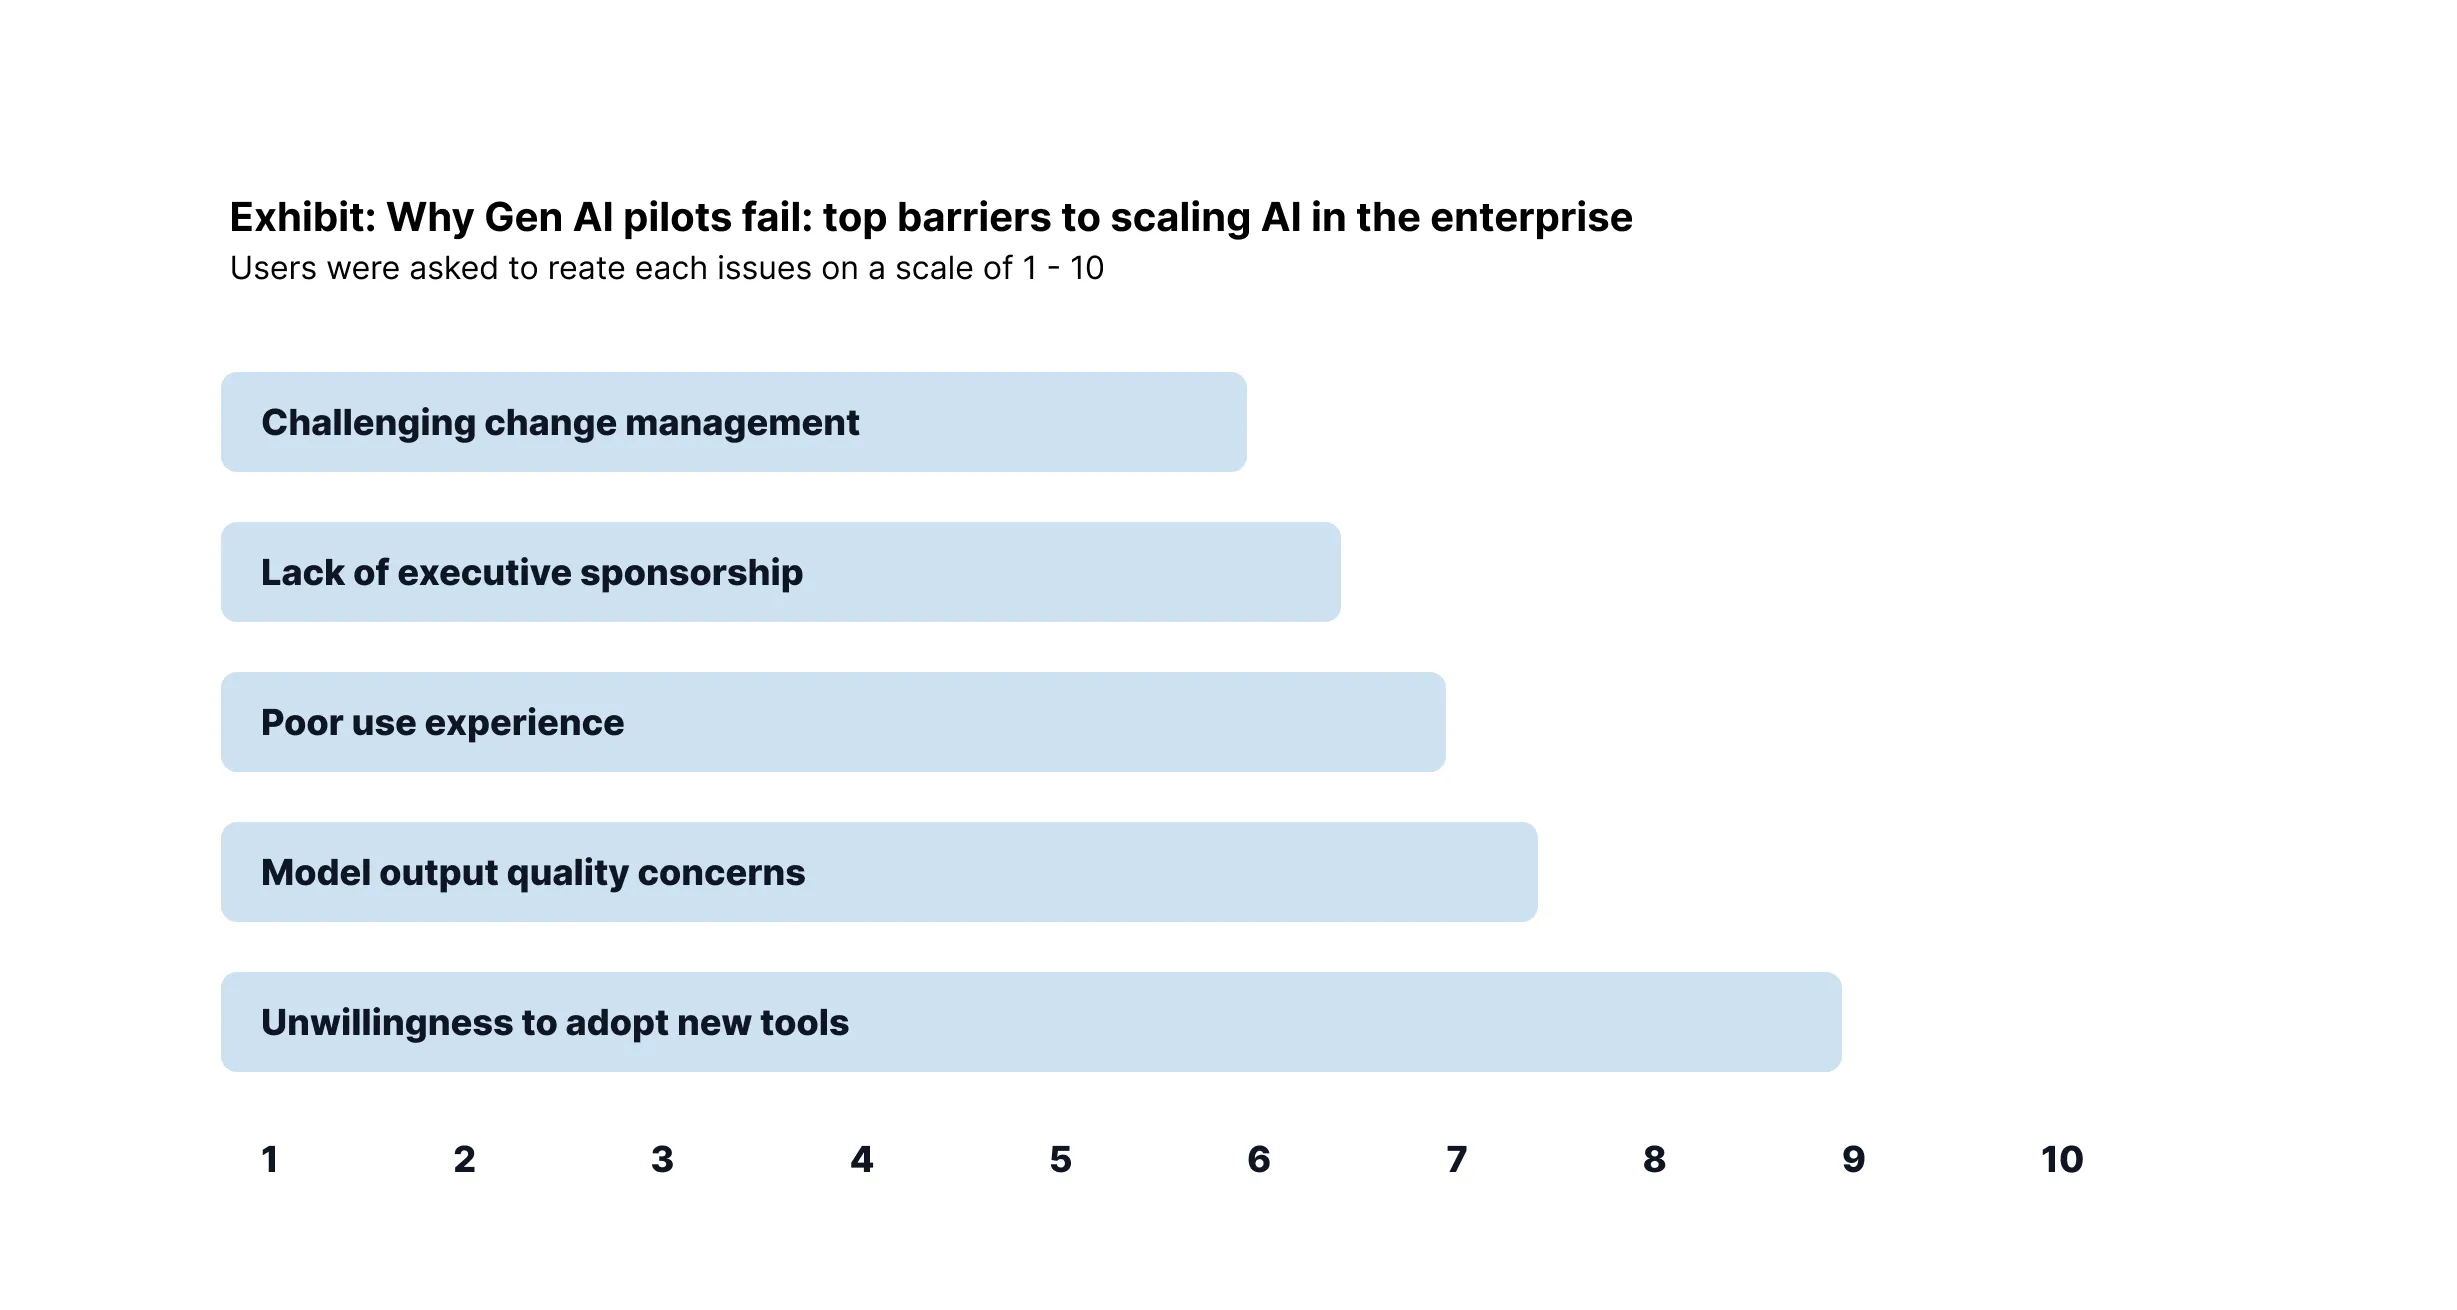
Um zu verstehen, warum so wenige GenAI-Pilotprojekte über die Versuchsphase hinauskommen, haben die Forschenden sowohl die Führungskräfte hinter den Vorhaben als auch die Nutzer an der Front in 52 Unternehmen befragt. Die Teilnehmenden sollten verbreitete Hürden für den Ausbau auf einer Häufigkeitsskala von 1 bis 10 bewerten, wobei 10 für die am häufigsten angetroffenen Hindernisse stand.
Die fünf größten Hürden für den Erfolg beim Ausbau von GenAI
Die Ergebnisse zeigten mehrere entscheidende Erkenntnisse dazu, warum GenAI-Pilotprojekte scheitern:
1. Unwille, neue Werkzeuge anzunehmen (Bewertung: 9/10): Die größte Hürde spiegelt grundlegenden Widerstand der Nutzer, und dieser Widerstand ist nicht willkürlich. Beschäftigte, die ChatGPT regelmäßig privat nutzen, lehnen KI-Werkzeuge des Unternehmens oft ab, weil sie im Vergleich sperrig und beschränkt wirken. Dieselben Fachleute, die KI täglich in ihren eigenen Abläufen nutzen, verlangen von den Systemen des Unternehmens ähnliche Beweglichkeit und Reaktionsfreude. Wie das MIT anmerkt:
„Nutzer schätzen die Beweglichkeit und Reaktionsfreude der LLM-Oberflächen für Endkunden, brauchen aber das dauerhafte Gedächtnis und das Kontextbewusstsein, die die heutigen Werkzeuge nicht bieten können.“
Aus Sicht von Dawiso hängt dieses fehlende Kontextbewusstsein oft am Datenfundament selbst. Wenn die KI-Werkzeuge eines Unternehmens nicht an sauber geregelte, hochwertige interne Daten angebunden sind, können sie die Einschlägigkeit und Verlässlichkeit nicht liefern, die Nutzer erwarten, und die Ablehnung wird fast unvermeidlich.
2. Zweifel an der Qualität der Modellausgaben (Bewertung: 7,5/10): Diese Hürde erwies sich als gewichtiger als erwartet und hängt unmittelbar mit Mängeln der Datenqualität zusammen. Ironischerweise beschreiben dieselben Nutzer, die ChatGPT und ähnliche Werkzeuge in ihre eigenen Abläufe einbinden, sie innerhalb der Systeme des Unternehmens als unzuverlässig. Dieser Widerspruch zeigt das GenAI Divide auf der Ebene der Nutzer: Werkzeuge für Endkunden gewinnen bei der Bedienbarkeit, Werkzeuge des Unternehmens verfehlen die Erwartungen an die Qualität.
3. Schlechte Bedienbarkeit (Bewertung: 7,0/10): KI-Werkzeuge im Unternehmen schneiden bei der Bedienung für die Nutzer durchweg schlechter ab als Alternativen für Endkunden. Eine Juristin im Unternehmen führte das vor: Ihr Haus investierte 50.000 $ in ein spezialisiertes Werkzeug zur Vertragsanalyse, und doch griff sie zum Entwerfen beständig zu ChatGPT, weil „unser gekauftes KI-Werkzeug starre Zusammenfassungen mit wenig Anpassungsmöglichkeiten lieferte“.
Das Problem kann entstehen, wenn Unternehmen von KI-Systemen äußerst präzise Ausgaben verlangen, was die Beweglichkeit und die Kreativität des Modells einschränken kann.
4. Fehlende Rückendeckung der Führung (Bewertung: 6,5/10): Ohne klare Unterstützung der Führung und strategische Richtung werden GenAI-Pilotprojekte oft zu verstreuten Versuchen, denen Fokus und Mittel für eine spürbare Wirkung fehlen.
5. Schwieriges Veränderungsmanagement (Bewertung: 6,5/10): Unternehmen tun sich schwer, KI-Werkzeuge in bestehende Abläufe und Prozesse einzubinden, was Reibung erzeugt und eine erfolgreiche Einführung und Ausweitung verhindert.
Die zentralen Datenprobleme hinter gescheiterten GenAI-Pilotprojekten
Die Hürden oben spiegeln tiefer liegende Probleme mit den Daten, die GenAI-Pilotprojekte am Erfolg hindern:
Verlust von Gedächtnis und Kontext: Heutige GenAI-Systeme haben kein dauerhaftes Gedächtnis, sodass Nutzer bei jeder Interaktion den vollständigen Kontext liefern müssen. Eine Führungskraft merkte an: „Es behält weder das Wissen über die Vorlieben der Kundschaft noch lernt es aus früheren Überarbeitungen. Es wiederholt dieselben Fehler und verlangt in jeder Sitzung umfangreiche Kontexteingaben.“
Unfähigkeit, aus Rückmeldungen zu lernen: Nutzer im Unternehmen berichten durchweg, dass KI-Systeme über die Zeit nicht besser werden. Anders als menschliche Assistenzen, die die Vorlieben und Abläufe eines Unternehmens lernen, bleiben heutige GenAI-Werkzeuge starr und machen dieselben Fehler immer wieder.
Fehlende Einbettung in Abläufe: Viele GenAI-Pilotprojekte scheitern, weil sie als eigenständige Werkzeuge bestehen statt als eingebundene Lösungen, die den jeweiligen Kontext und die Datenmuster eines Unternehmens verstehen und sich daran anpassen.
Was wir bei Dawiso aus der Praxis außerdem wissen:
Das Problem „Garbage in, Garbage out“
Viele GenAI-Pilotprojekte scheitern, weil sie auf ungeregelten Datenquellen aufsetzen. Ein typisches Beispiel sind Unternehmen, die KI an SharePoint-Ablagen hängen, in denen zehn Fassungen desselben Dokuments liegen. Die KI wählt zufällig, welche Fassung sie nutzt, was zu verwirrten und uneinheitlichen Antworten führt. Ohne saubere Governance der Dokumente und Versionskontrolle liefern selbst die ausgefeiltesten KI-Modelle unzuverlässige Ausgaben.
Warum allgemeine Werkzeuge gewinnen und verlieren
Die Untersuchung zeigte einen auffälligen Widerspruch in den Vorlieben der Nutzer. Fachleute, die sich skeptisch über KI-Werkzeuge des Unternehmens äußerten, waren oft starke Nutzer von LLM-Oberflächen für Endkunden. Auf die Bitte, ihre Erfahrungen zu vergleichen, traten drei wiederkehrende Themen hervor:
1.) Was die Vorliebe treibt: allgemeine LLM-Oberfläche gegen eingebundenes Werkzeug
Nach den Daten der Untersuchung ziehen Nutzer allgemeine Werkzeuge wie ChatGPT den Lösungen des Unternehmens aus mehreren Gründen vor:
- „Die Antworten sind besser“ (80 % der Befragten)
- „Ich kenne die Oberfläche schon“ (70 % der Befragten)
- „Ich traue ihr mehr“ (60 % der Befragten)
Diese Vorliebe zeigt eine grundlegende Spannung. Dieselben Fachleute, die ChatGPT täglich für eigene Aufgaben nutzen, verlangen für die Arbeit im Unternehmen Lernfähigkeit und Gedächtnis. Eine beträchtliche Zahl von Arbeitenden nutzt KI-Werkzeuge bereits privat und berichtet von Produktivitätsgewinnen, während die förmlichen KI-Vorhaben ihrer Unternehmen stocken.
2.) Die Lernlücke, die das GenAI Divide ausmacht
Trotz der Vorliebe für LLM-Oberflächen für Endkunden untersuchten die Forschenden, was eine breitere Nutzung für geschäftskritische Arbeit verhindert. Die Hürden hier unterschieden sich deutlich von allgemeinen Fragen der Bedienbarkeit und beleuchteten unmittelbar die Lernlücke, die das GenAI Divide ausmacht.
Zu den zentralen Grenzen, die eine Nutzung im Unternehmen verhindern, gehören:
- „Es lernt nicht aus unseren Rückmeldungen“ (65 % der Nutzer)
- „Jedes Mal ist zu viel manueller Kontext nötig“ (60 % der Nutzer)
- „Wir können es nicht an unsere Abläufe anpassen“ (55 % der Nutzer)
- „Es bricht in Sonderfällen und passt sich nicht an“ (50 % der Nutzer)
3.) Wahrgenommene Eignung für folgenreiche Arbeit
Als Nutzer im Unternehmen verschiedene Möglichkeiten für folgenreiche Arbeit bewerten sollten, wurde die Rangfolge über eine vielsagende Frage deutlich: „Würden Sie diese Aufgabe einer KI oder einer Nachwuchskraft geben?“
Die Schwierigkeit der Aufgabe entscheidet über die Annahme von KI
Die Ergebnisse zeigen, dass KI den Kampf um die einfache Arbeit bereits gewonnen hat:
- 70 % bevorzugen KI für schnelle Aufgaben (E-Mails, Zusammenfassungen, einfache Auswertungen)
- 30 % bevorzugen Menschen für schnelle Aufgaben
Bei allem Komplexen oder Langfristigen überwiegen Menschen jedoch mit großem Abstand:
- 10 % bevorzugen KI für komplexe Vorhaben (Arbeit über mehrere Wochen, Betreuung von Kundschaft)
- 90 % bevorzugen Menschen für komplexe Vorhaben
Die Trennlinie ist nicht die Intelligenz... es sind Gedächtnis, Anpassungsfähigkeit und Lernfähigkeit, also genau die Eigenschaften, die die beiden Seiten des GenAI Divide trennen.
Was Unternehmen wirklich wollen
Die erfolgreichsten Anbieter verstehen, dass das Überqueren des GenAI Divide Systeme verlangt, die Führungskräfte immer wieder betont haben: KI-Systeme, die nicht nur Inhalte erzeugen, sondern in ihrer Umgebung lernen und besser werden.
Prioritäten der Führung bei der Auswahl von GenAI-Anbietern
Bei der Bewertung von KI-Werkzeugen betonten Käufer durchweg bestimmte Prioritäten, die aus den Gesprächen abgeleitet und nach Kategorien geordnet wurden:
- Ein Anbieter, dem wir trauen (90 % Wichtigkeit)
- Tiefes Verständnis unserer Abläufe (75 % Wichtigkeit)
- Möglichst wenig Störung der heutigen Werkzeuge (70 % Wichtigkeit)
- Klare Grenzen für Daten (65 % Wichtigkeit)
- Die Fähigkeit, über die Zeit besser zu werden (60 % Wichtigkeit)
- Beweglichkeit, wenn sich Dinge ändern (50 % Wichtigkeit)
Diese Prioritäten zeigen, dass gelungene GenAI-Einführungen mehr brauchen als mächtige Modelle: Sie brauchen Systeme, die den Kontext des Unternehmens verstehen, die Sicherheit der Daten wahren und sich fortlaufend an die jeweiligen Bedürfnisse des Geschäfts anpassen.
Warum lernende KI gewinnt
Das Fenster, um das GenAI Divide zu überqueren, schließt sich rasch. Unternehmen verlangen zunehmend Systeme, die sich über die Zeit anpassen. Microsoft 365 Copilot und Dynamics 365 bauen dauerhaftes Gedächtnis und Rückmeldeschleifen ein. Die Gedächtnis-Beta von ChatGPT bei OpenAI deutet auf ähnliche Erwartungen an Werkzeuge für allgemeine Zwecke.
Unternehmen, die in KI-Systeme investieren, die aus ihren Daten, Abläufen und Rückmeldungen lernen, bauen Wechselkosten auf, die Monat für Monat wachsen. Ein CIO eines Finanzdienstleisters mit einem Volumen von 5 Mrd. $ erklärte: „Wir bewerten gerade fünf verschiedene GenAI-Lösungen, aber welches System unsere Prozesse am besten lernt und sich daran anpasst, wird am Ende unser Geschäft gewinnen. Haben wir erst Zeit investiert, um einem System unsere Abläufe beizubringen, werden die Wechselkosten unerschwinglich.“
Die Lösung von Dawiso: die Krise von Kontext und Daten hinter GenAI-Fehlschlägen lösen
Der MIT-Bericht zeigt, dass die meisten GenAI-Pilotprojekte stocken, weil KI-Systeme sich nicht erinnern, sich nicht anpassen und keinen Kontext liefern können. Ab Werk versteht KI keine Geschäftsprozesse. In der Praxis läuft der fehlende Kontext aber oft auf Qualität und Governance der genutzten Daten hinaus. Sind die Eingaben unordentlich, veraltet oder doppelt, kann das System nicht wirksam lernen.
Indem Dawiso sowohl strukturierte als auch unstrukturierte Daten regelt, sorgt es dafür, dass KI-Systeme nur mit einschlägigen, freigegebenen und hochwertigen Informationen arbeiten, und macht aus dem Kontext eine Stärke statt einer Schwäche.
1.) Fehlender Kontext und ungeregelte fachliche Informationen
Dawiso wirkt als Karte Ihrer Daten für glaubwürdige KI. Mit Dawiso kann KI interne Definitionen verstehen, die richtigen Datenquellen finden und innerhalb der Geschäftsregeln arbeiten, die für Ihr Unternehmen zählen. Statt allgemeiner Antworten liefert Ihre KI einschlägige, genaue Ausgaben und fügt sich in bestehende Abläufe ein.
Dawiso geht das Grundproblem an, an dem die meisten GenAI-Pilotprojekte scheitern: den richtigen Kontext zur richtigen Zeit zu liefern. Die Plattform hilft Unternehmen, ihre Datenquellen zu kartieren, und sorgt dafür, dass KI-Systeme nur mit einschlägigen, freigegebenen Inhalten arbeiten.
2.) Die Lernlücke über das Erfassen von Unternehmenswissen schließen
Die Untersuchung des MIT stellte fest, dass gelungene GenAI-Einführungen Systeme verlangen, die mit dem Kontext des Unternehmens lernen und sich anpassen. Dawiso ermöglicht das, indem es das Wissen erfasst und regelt, das heute nur in den Köpfen der Beschäftigten existiert.
A) Eingängiges Erfassen von Wissen: Dawiso erkennt an, dass viel Wissen über Prozesse, Berechnungen von Kennzahlen und fachliche Zusammenhänge nur in den Köpfen der Beschäftigten steckt. Die eingängige Oberfläche der Plattform ermuntert Nutzer, dieses Wissen festzuhalten und zu teilen:
- Suche im Stil von Google: Eine Oberfläche in natürlicher Sprache, die Beschäftigte ermuntert, mit dem Wissensbestand des Unternehmens zu arbeiten und zu ihm beizutragen
- Anbindung an Slack: Nahtlose Einbindung in bestehende Werkzeuge zur Zusammenarbeit, um Wissen dort zu erfassen, wo es natürlich entsteht
- Nutzerfreundliche Dokumentation: Macht es den Fachbereichen leicht, Prozesse und Zusammenhänge zu dokumentieren, ohne technisches Fachwissen zu verlangen
B) Einbindung des fachlichen Kontexts: Dawiso verknüpft Dokumente automatisch mit Business Glossaries, KPIs und Abläufen und gibt KI-Systemen damit den reichen Kontext, den sie brauchen:
- Automatische Verknüpfung: Verbindet Begriffe mit Business Glossaries und Datenquellen und ergänzt Dokumente in Echtzeit um Kontext
- Abbildung der Beziehungen: Verfolgt Beziehungen zwischen Dokumenten über die Zeit und hilft KI zu verstehen, wie Richtlinien, Vorlagen und Prozesse zusammenhängen
- Einbindung in Abläufe: Verknüpft Dokumente mit bestimmten Geschäftsprozessen, sodass KI versteht, wann und wie Informationen anzuwenden sind
3.) Das Datenfundament für anpassungsfähige KI schaffen
Der Weg von Dawiso begegnet den zentralen Hürden aus der Untersuchung des MIT unmittelbar, indem er ein geregeltes Datenfundament schafft.
A) Anbindung an das Model Context Protocol (MCP): Alle in Dawiso geregelten Metadaten werden über das Model Context Protocol aufbereitet, sodass unstrukturierte Daten nicht nur gesteuert, sondern auch bereit sind, von KI-Agenten sicher und wirksam genutzt zu werden. Das trifft die Erwartung der Unternehmen an KI-Systeme, die den Kontext des Unternehmens verstehen und über die Zeit besser werden.
B) Skalierbare Zugriffskontrolle: Der Governance-Rahmen von Dawiso sorgt dafür, dass KI-Systeme die Grenzen und Zugriffsregeln des Unternehmens achten:
- Rollenbasierter Zugriff: Weist Rollen für Beitragende und Lesende zu, um zu steuern, wer Dokumente bearbeiten und sehen darf, sodass KI die Hierarchien des Unternehmens achtet
- Grenzen für Daten: Liefert die klaren Grenzen für Daten, die Führungskräfte bei der Auswahl von GenAI-Anbietern als entscheidend benannt haben
- Zuweisung von Verantwortung: Weist jedem Dokument klare Verantwortliche und Beteiligte zu und stützt damit Rechenschaft und Zugriffsrichtlinien für KI
C) Fortlaufende Verbesserung über geregelte Rückmeldungen: Anders als starre KI-Werkzeuge im Unternehmen schafft Dawiso die Infrastruktur, damit KI-Systeme über die Zeit besser werden:
- Verfolgen von Änderungen: Beobachtet, wie sich Dokumente und Prozesse entwickeln, sodass KI-Systeme mit den Änderungen im Unternehmen aktuell bleiben
- Einbindung von Rückmeldungen: Erfasst, wie Nutzer mit dem Wissen des Unternehmens arbeiten und es ändern, sodass KI-Systeme aus echten Nutzungsmustern lernen können
- Qualitätssicherung: Sorgt dafür, dass KI-Systeme auch dann mit genauen, freigegebenen Informationen arbeiten, wenn sich das Wissen des Unternehmens weiterentwickelt
Praktische Umsetzung: vom Pilotprojekt in den Produktivbetrieb
Der Weg von Dawiso hat sich in großen Einführungen bewährt. Unsere Arbeit mit Kunden hat bestätigt, wie ein sauberer Katalog der Bestände gelungene GenAI-Einführungen in komplexen Unternehmen ermöglicht, in denen interne Dokumentation, Prozessbeschreibungen und Verfahren über mehrere Systeme und Teams hinweg einheitlicher Governance unterliegen müssen.
Zentraler Nutzen für den Erfolg mit GenAI:
- Schnellere Einführung: Rasche Inbetriebnahme ohne monatelange Projekte, die GenAI-Vorhaben oft ins Stocken bringen
- Gleichbleibende Leistung der KI: Sorgt dafür, dass KI-Systeme verlässliche, genaue Antworten liefern, indem sie mit geregelten Datenquellen arbeiten
- Skalierbares Wissensmanagement: Trägt Tausende von Nutzern, die gemeinsam an der Governance arbeiten, ohne das Budget zu sprengen
- Bereit zur Anbindung: Arbeitet mit bestehenden Werkzeugen und Systemen, hält die Störung klein und die Wirkung der KI groß
Indem Dawiso die grundlegenden Aufgaben bei den Daten angeht, die die Untersuchung des MIT benennt, versetzt es Unternehmen in die Lage, das GenAI Divide zu überqueren und von probeweisen Pilotprojekten zu produktiven KI-Systemen zu kommen, die über ein sauberes Datenfundament und fortlaufendes Lernen im Unternehmen messbaren geschäftlichen Wert liefern.
Fazit
Die Untersuchung des MIT macht deutlich, dass das GenAI Divide nicht von Dauer ist, dass es zu überqueren aber grundlegend andere Entscheidungen über Data Governance, Partnerschaften bei der Technik und den Aufbau des Unternehmens verlangt. Die Quote von 95 % gescheiterter GenAI-Pilotprojekte liegt nicht an unzureichenden KI-Modellen oder zu wenig Rechenleistung; sie rührt vor allem von Aufgaben bei Daten und Metadaten her, die KI-Systeme daran hindern, auf das Wissen des Unternehmens zuzugreifen, es zu verstehen und daraus zu lernen.
Für Unternehmen, die derzeit auf der falschen Seite des GenAI Divide feststecken, führt der Weg nach vorn über mehr als die Wahl besserer KI-Modelle. Erfolg verlangt:
- Zuerst die Metadaten angehen: Bevor sie KI-Systeme einführen, müssen Unternehmen eine saubere Governance für ihre strukturierten und unstrukturierten Datenquellen aufbauen. Dazu gehören Versionskontrolle, Verwaltung von Zugriffen und die Anreicherung der Metadaten, die KI-Systemen erlaubt, den Kontext des Unternehmens zu verstehen.
- Eine lernfähige Infrastruktur bauen: Weg von starren Werkzeugen, die ständiges Prompten brauchen, hin zu anpassungsfähigen Systemen, die aus Rückmeldungen, Dokumenten und Abläufen des Unternehmens lernen. Das verlangt katalogisierte Datenquellen und klare Wege für Rückmeldungen.
- Auf das Erfassen von Wissen setzen: Anerkennen, dass viel Wissen des Unternehmens nur in den Köpfen der Beschäftigten existiert, und eingängige Systeme schaffen, um dieses Wissen zu erfassen, zu regeln und KI-Systemen verfügbar zu machen.
- Anbindung vor Neuerung stellen: Statt den neuesten KI-Modellen hinterherzujagen, richten erfolgreiche Unternehmen ihre Aufmerksamkeit darauf, KI-Systeme mit sauber geregelten Unternehmensdaten und bestehenden Abläufen zu verbinden.
Der Schlüssel zum Erfolg mit GenAI liegt darin, die zugrunde liegenden Mängel der Datendokumentation anzugehen, an denen Pilotprojekte scheitern: fehlendes geordnetes Gedächtnis des Unternehmens, fehlende Kontext-Metadaten und die Unfähigkeit, die Standards der Datenqualität zu halten, die KI-Systeme brauchen. Während sich das Fenster für strategische Investitionen in KI schließt, müssen Unternehmen Lösungen voranstellen, die saubere Datenfundamente schaffen, statt einfach mächtigere Modelle auf bestehendes, ungeregeltes Datenchaos zu setzen.
Erfolg mit KI im Unternehmen verlangt, die probeweise Haltung hinter sich zu lassen und zu Systemen zu kommen, die auf sauber geregeltes Unternehmenswissen zugreifen, es verstehen und daraus lernen können, also zu genau den Eigenschaften, die gewinnende Unternehmen von jenen trennen, die im Dauerpilotbetrieb feststecken. Beim GenAI Divide geht es nicht um die Fähigkeit der Technik; es geht um die Bereitschaft des Unternehmens, KI-Systeme mit den strukturierten, kontextbezogenen Informationen zu versorgen, die sie zum Gelingen brauchen.