Einen Context Layer für KI im Unternehmen umsetzen: eine Anleitung Schritt für Schritt
Ein Context Layer gibt der KI die geregelte fachliche Bedeutung, die sie braucht, um Ihre Daten richtig zu nutzen. Einen aufzubauen klingt nach einem Infrastrukturprojekt über mehrere Quartale, und von Grund auf ist es das auch. Auf dem richtigen Fundament ist es eine Folge gut verstandener Schritte, die sich in Wochen abarbeiten lässt. Hier ist diese Folge, Schritt für Schritt, vom Katalog über die Bereitstellung per MCP bis zum Pflegen der Schicht.
Was ein Context Layer ist (und was er löst)
Ein KI-Werkzeug kann nur so gut sein wie das, was es über Ihr Geschäft versteht. Ein Modell kann eine Tabelle lesen, aber es weiß von sich aus nicht, dass „aktiver Kunde“ abgesprungene Testkonten ausschließt, dass eine Umsatzspalte nach Abzug von Erstattungen ausgewiesen wird oder dass von zwei ähnlich benannten Datensätzen einer die freigegebene Quelle ist. Ein Context Layer ist die geregelte Schicht, die genau das liefert: die fachliche Bedeutung, die Beziehungen, die Vertrauenssignale und die Zugriffsregeln, die eine KI braucht, um Ihre Daten richtig zu nutzen.
Es lohnt sich, genau zu sein, worin sich das von einem Semantic Layer unterscheidet. Ein Semantic Layer übersetzt technische Daten in die Sprache des Geschäfts, damit KI weiß, was Ihre Begriffe bedeuten. Ein Context Layer umfasst das und legt Lineage, Governance und Herkunft obendrauf, um das Ganze dann über eine standardisierte Verbindung an KI-Werkzeuge auszuliefern. Der Semantic Layer ist ein Stockwerk, der Context Layer das ganze Gebäude, einschließlich des Teils, der Antworten belastbar macht, und des Teils, der sie ausliefert. Dieser Leitfaden geht den Aufbau in sechs Schritten durch.
Schritt 1: das Fundament mit einem Katalog bauen
Kontext lässt sich nicht für Daten regeln, die man nicht sieht. Der erste Schritt ist ein Datenkatalog, der erfasst, welche Datenbestände es in Ihrer Landschaft gibt, wo sie liegen und wie sie zusammenhängen. Binden Sie Ihre Quellen an, Warehouses, Lakehouses, BI-Werkzeuge und operative Systeme, und lassen Sie den Katalog sie in ein einziges, durchsuchbares Verzeichnis einlesen.
Das Ergebnis dieses Schritts ist Abdeckung: ein vollständiges Bild der Tabellen, Spalten, Berichte und Datensätze, nach denen eine KI gefragt werden könnte. An dieser Schicht hängt alles Weitere. Bedeutung, Vertrauen und Richtlinien hängen alle an Katalogeinträgen, also erzeugt ein unvollständiger Katalog einen Context Layer mit blinden Flecken, mit Stellen, an denen die KI unbemerkt ins Raten verfällt. Zielen Sie zuerst auf Breite; einzelne Bestände vertiefen Sie in den folgenden Schritten.
Schritt 2: Bedeutung mit einem Glossar ergänzen
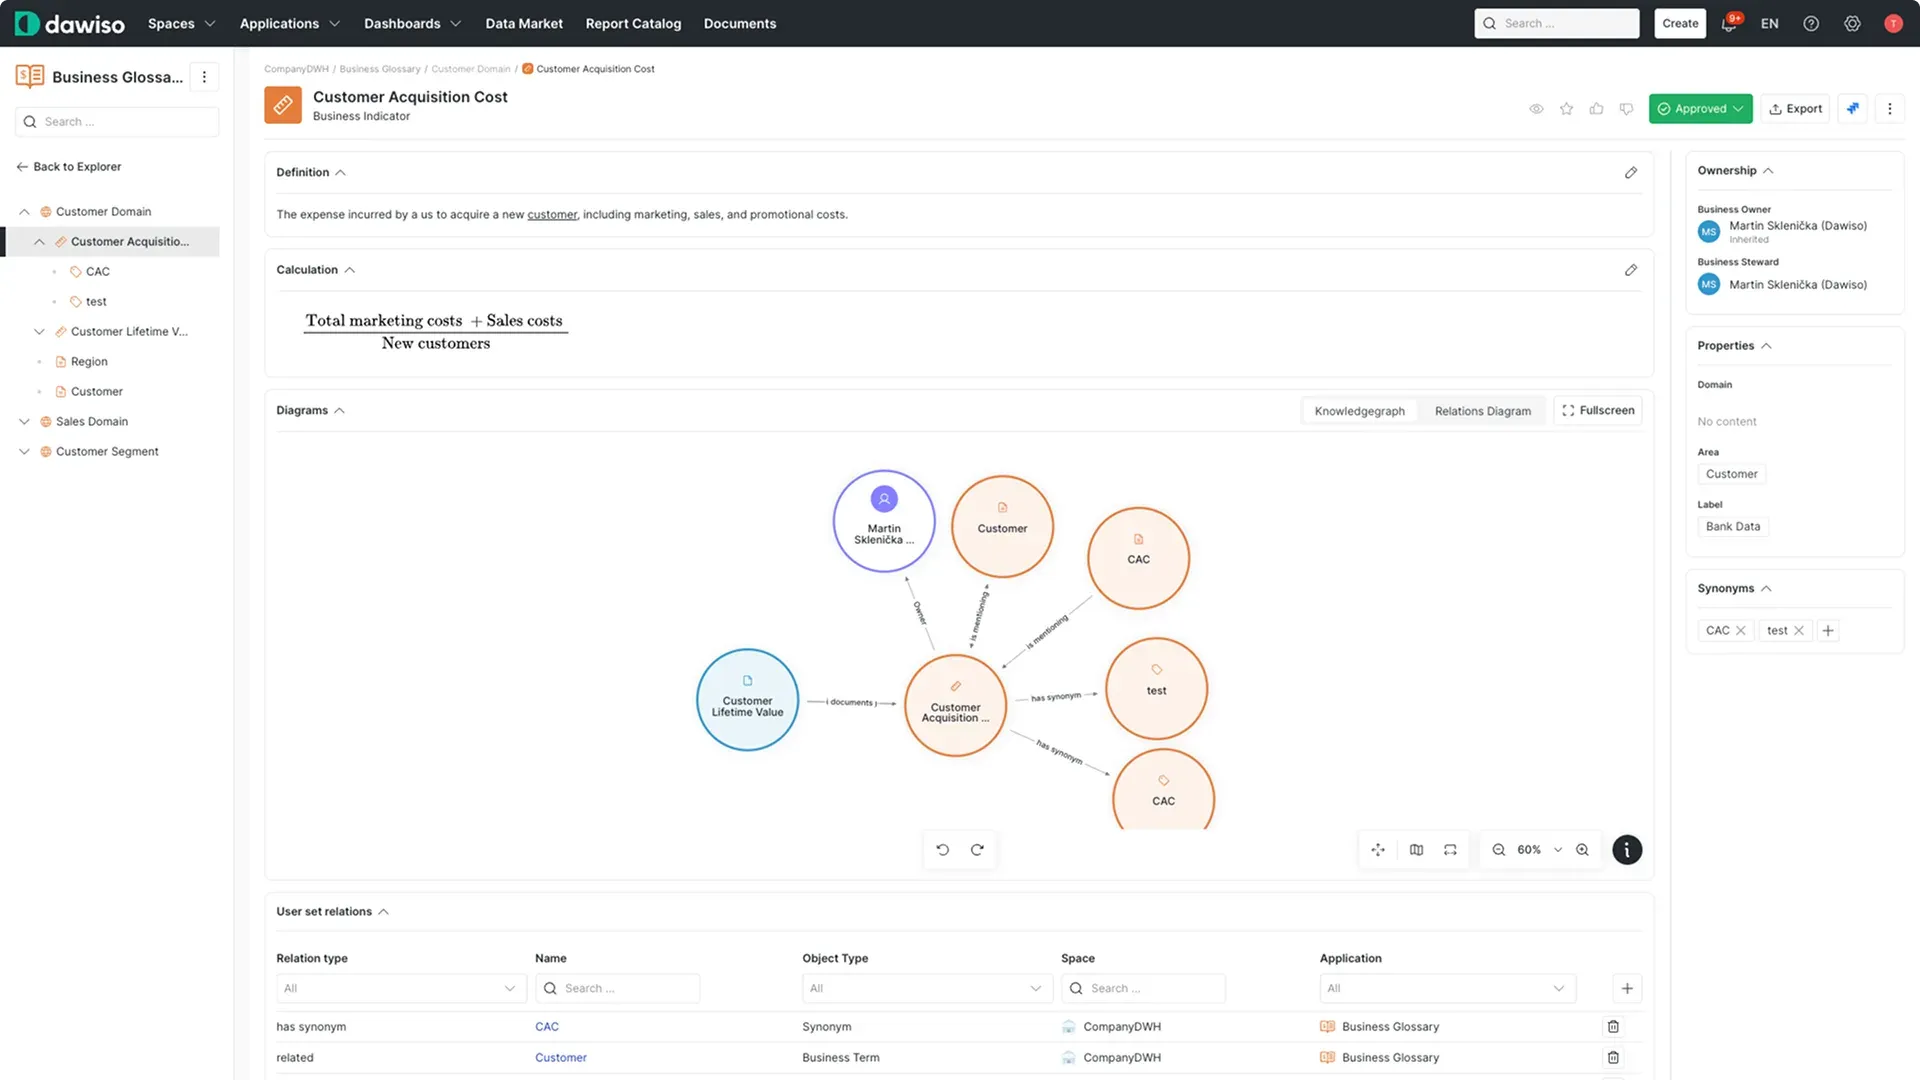
Ein Katalog sagt der KI, was es gibt. Ein Business Glossary sagt ihr, was diese Dinge bedeuten. Hier definieren Sie Ihre Kennzahlen und Entitäten einmal und verbindlich: was „aktiver Nutzer“, „Nettoumsatz“ oder „qualifizierter Lead“ in Ihrem Geschäft tatsächlich bezeichnet, samt der Randfälle, über die jede neue Analystin und jeder neue Analyst stolpert.
Verknüpfen Sie jede Definition mit den Beständen im Katalog, die sie umsetzen, damit Bedeutung und Daten verbunden sind und nicht in getrennten Dokumenten liegen. Das ist der semantische Kern des Context Layer und der Schritt mit der größten Hebelwirkung: Ein Modell, das Ihre Definitionen kennt, deutet abgerufene Daten richtig, und eines ohne sie meldet überzeugt die falsche Zahl. Definitionen sollten von denen verfasst werden, denen sie gehören, von Fachleuten und Verantwortlichen, und nicht von dem improvisiert werden, der gerade den Prompt geschrieben hat.
„Eine Kennzahl, die an einer geregelten Stelle definiert ist, ist mehr wert als dieselbe Kennzahl, die zehnmal in zehn Werkzeugen definiert wird.“
Schritt 3: Vertrauen mit Lineage schaffen
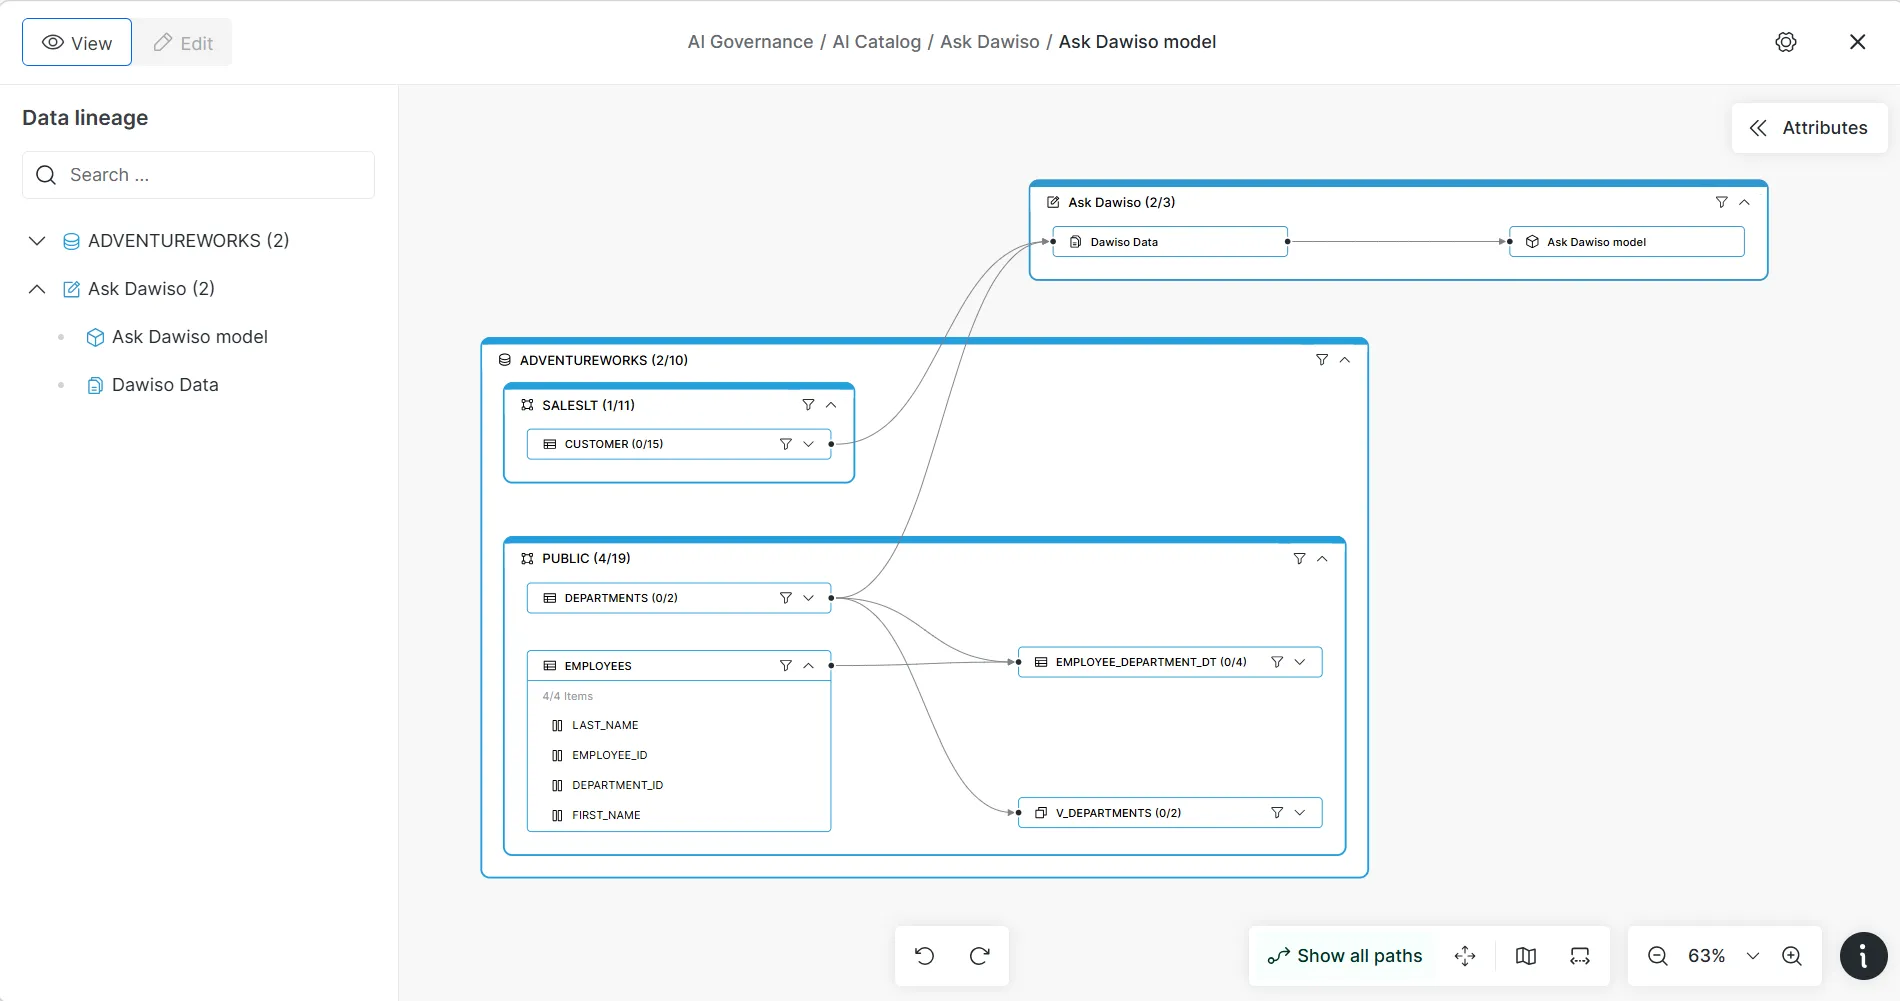
Zu wissen, was Daten bedeuten, ist nicht dasselbe wie zu wissen, ob man ihnen trauen kann. Schritt drei ergänzt Data Lineage: eine nachvollziehbare Karte, woher jeder Bestand kommt, was ihn verändert hat und was von ihm abhängt. Lineage ist das, was eine KI-Antwort bis zur Quelle zurückverfolgbar macht, und das, was Sie erkennen lässt, bevor ein Problem das Modell erreicht, dass eine Definition von einer Pipeline gespeist wird, die letzte Nacht ausgefallen ist.
Verbinden Sie Lineage mit einfachen Qualitätssignalen, also Aktualität, Vollständigkeit und der Frage, ob ein Bestand zertifiziert oder ausgemustert ist, damit der Context Layer eine verbindliche Quelle von einer veralteten Kopie unterscheiden kann. Lineage macht aus „wir glauben, die Daten sind in Ordnung“ etwas, das eine KI und eine Prüferin gleichermaßen nachvollziehen können. Im Zeitalter der Agenten ist das keine Nettigkeit: Ein Agent, der auf einer nicht nachvollziehbaren Zahl handelt, ist ein Risiko für Compliance und Betrieb, nicht nur ein falsches Dashboard.
Schritt 4: Richtlinien und Klassifizierung anhängen
Ein KI-Werkzeug, das Ihre Daten versteht, muss auch wissen, was es damit tun darf. Schritt vier hängt Klassifizierung und Zugriffsregeln an den Katalog: welche Felder PII oder andere sensible Daten enthalten, wie damit umzugehen ist und wer, oder welcher Agent, sie sehen darf.
Das ist die Schicht, die KI unter Regelwerken wie der DSGVO und dem EU AI Act regelkonform hält. Ohne sie kann ein fähiger Assistent eine Gehaltstabelle oder die personenbezogenen Daten einer Kundin jedem zeigen, der die richtige Frage stellt. Mit ihr wird sensibler Kontext an der Quelle geregelt, sodass die Regel mit den Daten in jedes Werkzeug wandert, das sie nutzt, statt in jedem einzeln und uneinheitlich neu umgesetzt zu werden. Eine einmal hier verfasste Klassifizierung sorgt dafür, dass „das Modell hat so entschieden“ eine Antwort ist, die Sie einer Aufsichtsbehörde nie geben müssen.
Schritt 5: Kontext über MCP bereitstellen
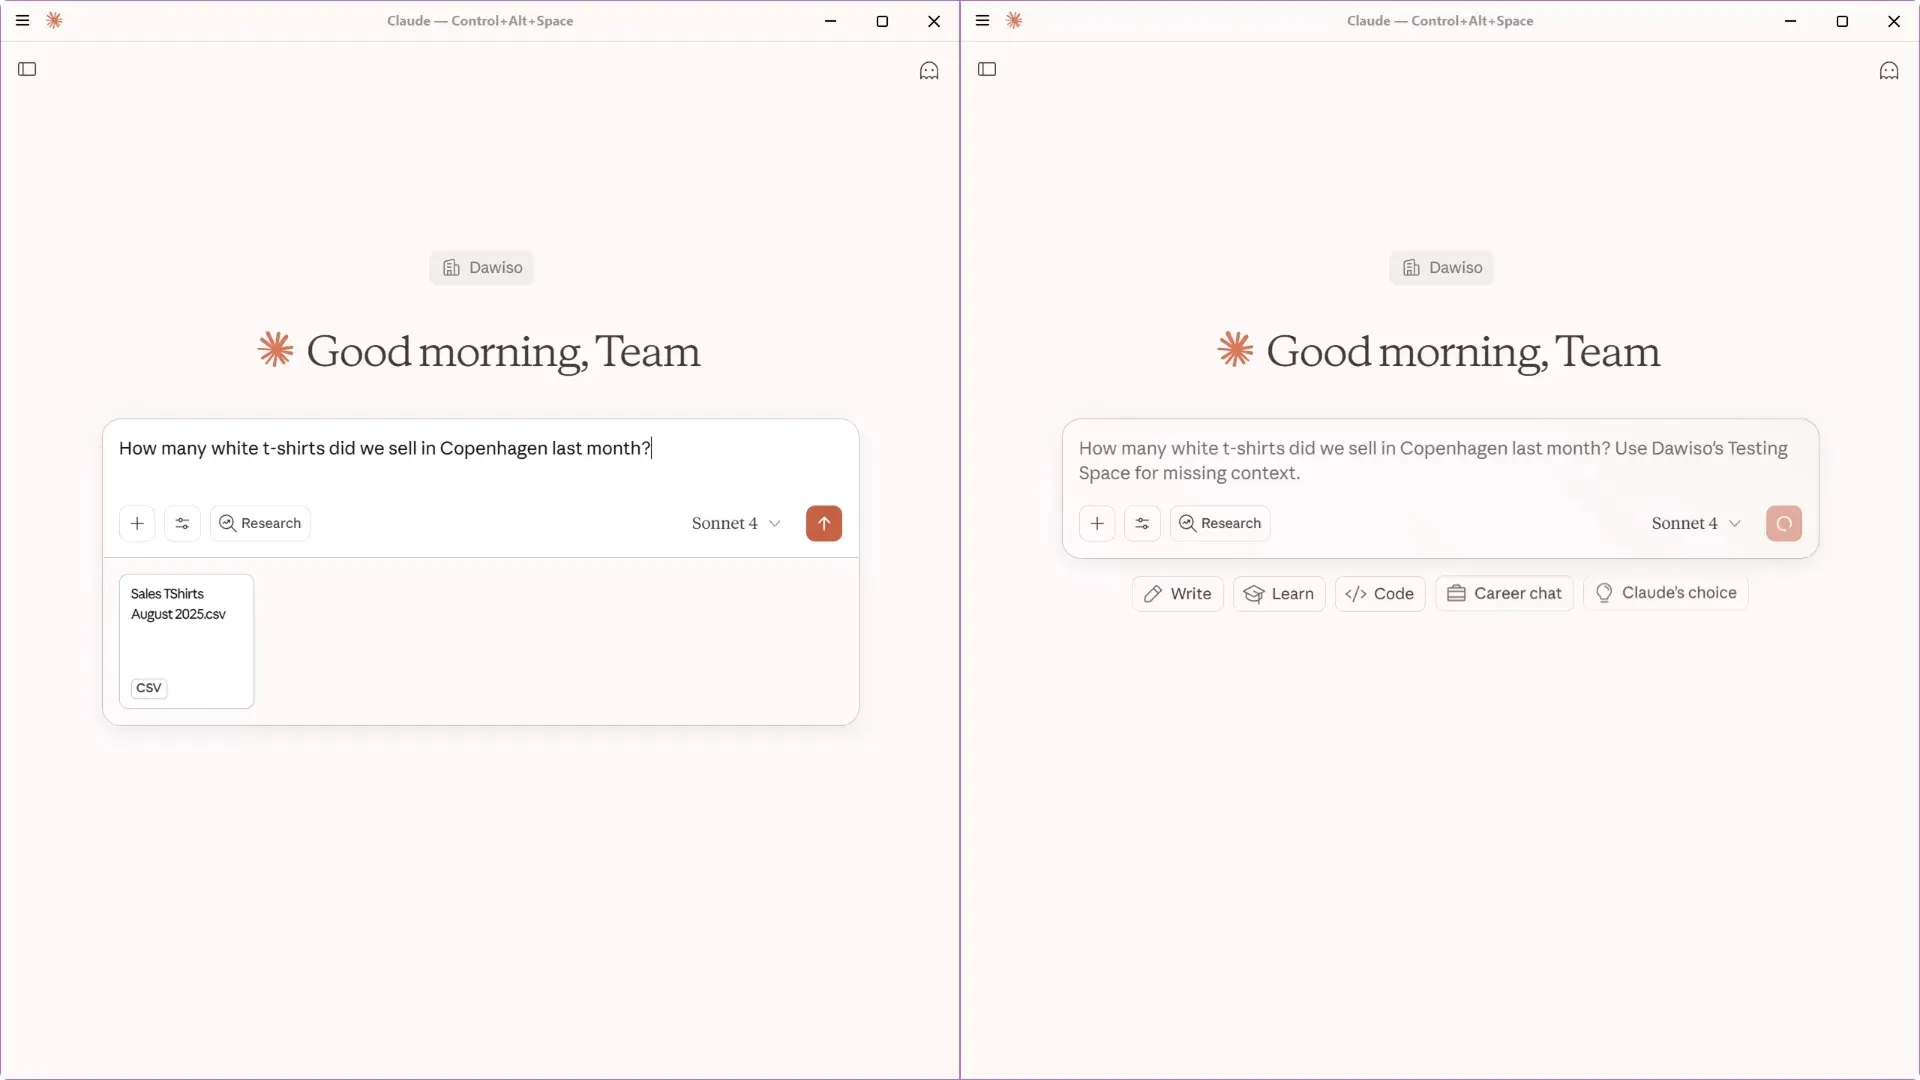
Die ersten vier Schritte regeln den Kontext. Schritt fünf liefert ihn aus. Ein geregelter Context Layer nützt der KI nichts, wenn er in dem Werkzeug eingeschlossen bleibt, das ihn gebaut hat, also brauchen Sie einen standardisierten Weg, ihn verfügbar zu machen. Dieser Standard ist das Model Context Protocol (MCP): ein offenes Protokoll, über das sich jeder kompatible Assistent und jeder kompatible Agent mit Ihrem Kontext verbinden und ihn bei Bedarf lesen kann.
Über einen MCP Server werden Ihr Katalog, Ihr Glossar, Ihre Lineage und Ihre Klassifizierung zu einem einzigen Endpunkt, den jedes KI-Werkzeug abfragen kann. Ein Copilot im Warehouse, ein BI-Assistent, eine eigene Anwendung und eine Agentenplattform greifen alle auf dieselben geregelten Definitionen und dieselben Regeln zu. Sie regeln den Kontext einmal und stellen ihn überall bereit, statt ihn in jedem Werkzeug neu zu bauen, und das nächste KI-Werkzeug, das Sie einführen, wird zu einem weiteren Abnehmer statt zu einem weiteren Silo, dem Fehlermuster, das wir unter Kontextsilos beschreiben.
Schritt 6: die Schicht über ihren Lebenszyklus am Leben halten
Ein Context Layer ist kein Projekt, das man abschließt, sondern ein Bestand, den man pflegt. Ihr Geschäft verändert sich, Definitionen entwickeln sich weiter, Pipelines verschieben sich, neue Quellen kommen hinzu. Ohne einen Lebenszyklus entfernt sich die Schicht von der Wirklichkeit, und ein Context Layer, der still veraltet, ist gefährlicher als gar keiner, weil ihm alle weiterhin vertrauen.
Lebenszyklus heißt ein paar konkrete Gewohnheiten: Freigabeabläufe, damit Änderungen an Definitionen von ihren Verantwortlichen geprüft werden, Versionierung, damit sichtbar bleibt, was sich wann geändert hat, Drift-Erkennung, die meldet, wenn die zugrunde liegenden Daten nicht mehr zu ihrer Definition passen (etwa durch Schema-Drift), und eine Rückkopplung, die falsche KI-Antworten in Korrekturen am Kontext übersetzt statt in einmaliges Flickwerk. Das ist Governance, laufend angewendet, und genau das hält die Schicht lange nach dem Starttag belastbar.
Wie lange dauert das?
Die ehrliche Antwort hängt davon ab, ob Sie die Infrastruktur bauen oder einrichten. Einen Context Layer von Grund auf zu bauen, also einen Knowledge Graph, einen Vektorspeicher, die Abruflogik und die Governance darum herum, ist ein Aufwand über mehrere Quartale für ein spezialisiertes Team, und es ist genau die Art von Eigenbau, die laut der MIT-Untersuchung weit häufiger scheitert als gelingt.
Auf einer Plattform, die die Bausteine bereits mitbringt, schrumpft der Zeitplan. In der Praxis haben die meisten Teams innerhalb eines Tages einen funktionierenden Katalog und ein Business Glossary, und ein vollständiger Context Layer, einschließlich KI-gestützter Anreicherung und MCP-Anbindung, steht in ein bis zwei Wochen, je nach Zahl der Quellen und Komplexität der Landschaft. Der Grund ist, dass die schwierigen Teile, also die Katalogmaschine, der Lineage-Graph, das Regelmodell und die Auslieferung über MCP, bereits existieren. Ihre Arbeit verschiebt sich vom Bauen der Infrastruktur zu dem, was nur Sie tun können: aufzuschreiben, was Ihr Geschäft meint.
Wie eine Plattform die Arbeit verkürzt
Drei Fähigkeiten einer Plattform machen aus den sechs Schritten eine Einrichtungsaufgabe statt eines Forschungsprojekts. Einheitliche Metadaten, sodass Katalog, Glossar, Lineage und Klassifizierung in einem verbundenen Modell liegen statt in vier getrennten Werkzeugen, die jedes für sich angebunden werden müssen. Automatische Anreicherung, sodass KI Beschreibungen, Vorschläge zur Verantwortlichkeit und Klassifizierung zur Prüfung durch Menschen entwirft und damit den Dokumentationsstau auflöst, an dem die meisten Governance-Vorhaben hängen bleiben. Und eingebaute Governance und Auslieferung, sodass Freigabeabläufe, Durchsetzung von Regeln und die Bereitstellung über MCP mitgeliefert und nicht angeflanscht werden.
Diese Kombination macht „einmal regeln, überall bereitstellen“ praktikabel. Sie flicken nicht Katalog, Glossar, Lineage-Werkzeug und einen selbst gebauten MCP Server zusammen, sondern richten eine Schicht ein, in der diese Belange bereits verbunden sind, und machen sie über eine Verbindung verfügbar.
Ihren Context Layer mit Dawiso aufbauen
Dawiso ist genau für diesen Weg gebaut. Es bindet mehr als 40 Plattformen an und fügt daraus ein einziges geregeltes Fundament zusammen: einen Data Catalog (Schritt 1), ein Business Glossary (Schritt 2), Interactive Data Lineage (Schritt 3) sowie Klassifizierung mit Governance-Abläufen (Schritte 4 und 6). Dawiso AI entwirft Beschreibungen, Verantwortlichkeiten und Klassifizierung zur Prüfung durch Menschen, weshalb das Fundament aus Katalog und Glossar in einem Tag steht statt in einem Quartal.
Über den Context Layer und seinen MCP Server (Schritt 5) stellt Dawiso diesen geregelten Kontext jedem MCP-fähigen Assistenten oder Agenten bereit, sodass jedes KI-Werkzeug aus denselben verlässlichen Definitionen liest, während Ihr Kontext in Ihrem Besitz und unter Ihrer Governance bleibt. Wenn Sie die begriffliche Grundlage hinter diesen Schritten suchen, behandelt unser Begleitartikel die Disziplin selbst: Context Engineering für Enterprise-KI. Die Datensilos abzubauen hat ein Jahrzehnt gedauert; ein geregelter Context Layer ist der Weg, sie nicht ein KI-Werkzeug nach dem anderen wieder aufzubauen.
FAQ
Was ist ein Context Layer für KI im Unternehmen?
Müssen wir den Context Layer von Grund auf selbst bauen?
Was ist der Unterschied zwischen einem Semantic Layer und einem Context Layer?
Welche Rolle spielt MCP in einem Context Layer?
Wie setzt Dawiso einen Context Layer um?
In Aktion erleben
Dawiso Context Layer
Regeln Sie den Kontext einmal und stellen Sie ihn dann jedem KI-Werkzeug und jedem Agenten über ein offenes Protokoll bereit.