Context Engineering für Enterprise-KI: die fehlende Schicht hinter belastbaren KI-Antworten
Das Modell ist selten der Grund, warum Enterprise-KI hinter den Erwartungen bleibt. Der Grund ist der Kontext: das, was das Modell vor seiner Antwort über Ihr Geschäft sehen kann. Context Engineering ist die Disziplin, das richtig hinzubekommen, und es ist die Schicht, die den meisten KI-Vorhaben noch fehlt. Hier steht, was sie ist, worin sie sich von Prompt Engineering und RAG unterscheidet, welche Schichten sie umspannt und warum geregelter Kontext der Teil ist, den Sie nicht überspringen können.
Warum bessere Modelle Enterprise-KI nicht reparieren
Die meisten Unternehmen haben inzwischen Zugang zu Modellen der Spitzenklasse, und die meisten sind von dem, was ihre KI liefert, immer noch enttäuscht. Die Lücke ist gut belegt. Die Untersuchung des MIT zu Enterprise-KI aus dem Jahr 2025 fand, dass 95 % der Pilotprojekte mit generativer KI keinen messbaren Ertrag brachten, trotz Ausgaben von mehreren Dutzend Milliarden US-Dollar, und führte das Scheitern nicht auf die Modelle zurück, sondern auf brüchige Abläufe und eine schwache Verankerung im Kontext (Fortune zum NANDA-Bericht des MIT). Über dasselbe Muster von der Datenseite her haben wir unter warum 95 % der GenAI-Pilotprojekte scheitern geschrieben.
Der Schluss daraus ist einheitlich: Der Engpass ist nicht mehr die reine Fähigkeit des Modells. Ein Modell, das ein juristisches Staatsexamen besteht, kann Ihrem Vertriebsteam trotzdem die falsche Umsatzzahl nennen, weil es nicht weiß, wie Ihr Geschäft Umsatz definiert. Was zwischen einem fähigen Modell und einer belastbaren Antwort steht, ist der Kontext, und ihn bewusst zu liefern ist eine Disziplin. Diese Disziplin hat einen Namen.
Was Context Engineering tatsächlich ist
Context Engineering ist die Praxis, zu entscheiden, was ein Modell vor seiner Antwort sieht, und dafür zu sorgen, dass diese Informationen richtig, einschlägig und geregelt sind. Ein Modell erzeugt seine Antwort aus dem, was im Moment der Anfrage in seinem Kontext steht. Context Engineering ist die Arbeit, dieses Fenster absichtlich zusammenzustellen, statt zu hoffen, das Modell wisse schon genug, oder ein geschickter Prompt werde die Lücken überdecken.
Im Unternehmen besteht der Kontext, den ein Modell braucht, aus mehreren verschiedenen Zutaten:
- Systemanweisungen, die Rolle, Ton und Grenzen des Modells festlegen.
- Abgerufenes Wissen, aus Ihren Dokumenten, Tabellen und Anwendungen für die konkrete Frage geholt.
- Fachliche Bedeutung, also die Definitionen von Kennzahlen und Entitäten und die Beziehungen zwischen ihnen, damit das Modell weiß, was Ihre Daten bedeuten.
- Werkzeugdefinitionen und ihre Ergebnisse, wenn das Modell Funktionen aufrufen, Systeme abfragen oder handeln kann.
- Gedächtnis und Gesprächsverlauf, damit das Modell den einschlägigen früheren Stand mitführt.
- Governance-Signale, also Klassifizierung, Zugriffsregeln, Verantwortlichkeiten und Vertrauenshinweise, die sagen, was das Modell nutzen darf und wie weit es sich darauf stützen kann.
Stimmt diese Mischung, wird ein fähiges Modell auf Ihren Daten wirklich nützlich. Stimmt sie nicht, oder überlässt man sie dem Zufall, halluziniert dasselbe Modell, widerspricht sich über Werkzeuge hinweg oder handelt nach einer Definition, auf die sich niemand geeinigt hat.
„Das Modell ist der Motor. Der Kontext ist der Treibstoff, die Karte und die Verkehrsregeln.“
Context Engineering und Prompt Engineering
Prompt Engineering und Context Engineering werden oft verwechselt, und der Unterschied zählt, weil er entscheidet, wer das Problem verantwortet. Prompt Engineering optimiert einen einzelnen Austausch: wie Sie die Frage formulieren, welche Beispiele Sie mitgeben, welche Anweisungen Sie dem Modell für eine Antwort erteilen. Das ist eine wertvolle persönliche Fähigkeit, und sie stößt an Grenzen. Kein noch so feines Justieren am Prompt kann eine Definition liefern, die das Modell nie bekommen hat.
Context Engineering optimiert das System um jeden Prompt herum: welche Quellen abgerufen werden, wie fachliche Bedeutung eingespeist wird, was herausgefiltert wird, wie Governance durchgesetzt wird und wie das alles zusammengestellt wird, bevor das Modell die Frage überhaupt sieht. Prompt Engineering ist etwas, das eine Person tut. Context Engineering ist eine Architektur, die ein Datenteam baut und verantwortet.
Ist das nur RAG unter neuem Namen?
Das ist eine berechtigte Frage, denn Retrieval-Augmented Generation (RAG) sieht aus der Ferne dem Context Engineering sehr ähnlich. Beide stellen dem Modell zusätzliche Informationen voran. Doch RAG ist eine Technik, und Context Engineering ist die Disziplin, die entscheidet, wie und wann man sie einsetzt.
RAG beantwortet eine Frage: Welche Dokumente oder Zeilen soll ich zu einer Anfrage holen und in den Prompt einfügen? Das ist notwendig, und es genügt nicht. RAG holt Text, der einschlägig aussieht; es hat keine Meinung dazu, ob dieser Text verbindlich ist, was die Begriffe darin bedeuten, wer ihn sehen darf oder ob sich zwei geholte Quellen widersprechen. RAG holt Inhalte; Context Engineering holt belastbare Bedeutung.
Context Engineering umgibt den Abruf mit dem, was ihn verlässlich macht: einer geregelten Definition jedes Geschäftsbegriffs, damit das Modell die geholten Daten richtig deutet, einer Klassifizierung, damit sensible Felder angemessen behandelt werden, und Lineage, damit sich eine Antwort auf eine verlässliche Quelle zurückführen lässt. Lässt man diese Schicht weg, holt RAG bereitwillig eine veraltete Tabelle und eine ausgemusterte Kennzahl mit derselben Überzeugung.
Die Schichten des Kontexts im Unternehmen
Es hilft, sich den Kontext im Unternehmen als Stack vorzustellen. Jede Schicht beantwortet eine andere Frage, und jede wird von jemand anderem verantwortet. Wenn KI hinter den Erwartungen bleibt, liegt das Problem fast immer an einer bestimmten Schicht, was den Stack ebenso zu einem nützlichen Diagnosewerkzeug macht wie zu einem Entwurf.
- Systemschicht: Rolle, Anweisungen und Leitplanken des Modells. Beantwortet: Wie soll sich das Modell verhalten?
- Abrufschicht: die Dokumente, Tabellen und Datensätze, die zur Frage geholt werden. Beantwortet: Was ist gerade einschlägig?
- Semantische Schicht: das Business Glossary und die Kennzahlendefinitionen. Beantwortet: Was bedeuten diese Daten in unserem Geschäft?
- Governance-Schicht: Klassifizierung, Zugriffsregeln und Richtlinien. Beantwortet: Was darf das Modell nutzen, und wie?
- Herkunftsschicht: Lineage und Vertrauenssignale. Beantwortet: Woher kommt das, und können wir uns darauf stützen?
Bei den oberen beiden Schichten fangen die meisten Teams an, weil sie die sichtbaren sind. An den unteren dreien scheitern die meisten Teams, weil sie die geregelten sind, und weil sie genau die Schichten sind, die ein Modell nicht aus sich heraus herstellen kann.
Warum ein größeres Kontextfenster nicht die Lösung ist
Eine verlockende Abkürzung ist, sich das Engineering zu sparen und das lange Kontextfenster arbeiten zu lassen: alles, was das Modell brauchen könnte, in einen riesigen Prompt kippen und darauf vertrauen, dass es das Wesentliche schon findet. Die Forschung sagt, das geht nach hinten los. Mit wachsender Eingabelänge sinkt die Genauigkeit des Modells, ein Fehlermuster, das zunehmend Context Rot genannt wird.
Eine Untersuchung von Chroma aus dem Jahr 2025 testete achtzehn Spitzenmodelle und stellte fest, dass jedes von ihnen schlechter abschnitt, je mehr Token hinzukamen, und zwar bei jeder getesteten Länge (Chroma, „Context Rot“). Frühere Arbeiten belegten den verwandten Effekt „lost in the middle“: Modelle nutzen Informationen am Anfang und am Ende eines langen Kontexts deutlich verlässlicher als solche, die in der Mitte vergraben sind (Liu et al., 2023). Nicht einschlägige, aber ähnlich aussehende Inhalte liegen dort nicht harmlos herum; sie ziehen das Modell aktiv zu falschen Antworten.
Das Ziel ist nicht, dem Modell den meisten Kontext zu geben. Es ist, ihm den richtigen zu geben. Ein genauer, geregelter, gut geordneter Kontext von wenigen tausend Token schlägt jedes Mal einen verrauschten Berg von hunderttausend Token, und er ist im Betrieb billiger.
Genau das ist der Wert, den Context Engineering gegenüber „einfach mehr abrufen“ hinzufügt. Es kuratiert. Es liefert die geregelte Definition statt zehn Dokumenten, die den Begriff erwähnen, und es lässt die Ablenkungen weg, die die Antwort sonst verschlechtern würden.
Was sich ändert, wenn Agenten die Analysten ablösen
Bis hierher liest sich das als Analyseproblem: Ein KI-Assistent beantwortet eine Frage, ein Mensch liest die Antwort, und eine falsche Zahl fällt bei der Prüfung auf. Agenten nehmen den Menschen aus dieser Schleife. Ein Agent antwortet nicht nur, er handelt, verkettet Schritte und ruft Werkzeuge auf, um eine Aufgabe über Systeme hinweg zu erledigen.
Das erhöht den Einsatz beim Kontext auf zwei Arten. Erstens macht ein Agent viele Modellaufrufe nacheinander, sodass sich ein einziges Missverständnis über jeden weiteren Schritt fortpflanzt. Zweitens ist eine falsche Antwort kein Satz mehr, den jemand nachprüft, sondern eine Handlung in Maschinengeschwindigkeit, verbreitet, bevor es jemand bemerkt. Context Engineering für Agenten muss deshalb disziplinierter sein, nicht lockerer: Jeder Schritt braucht den richtigen geregelten Kontext, und der Agent muss wissen, welche Quellen verbindlich sind und welche Daten er anfassen darf. Die Kosten einer Kontextlücke steigen von „peinlich“ auf „betrieblich“.
Genau deshalb wird zersplitterter Kontext im Zeitalter der Agenten gefährlich. Wenn jede Agentenplattform ihren eigenen, abgeschotteten Bestand an Bedeutung aufbaut, bekommen Sie uneinheitlichen, ungeregelten Kontext, vervielfacht über Werkzeuge hinweg, ein Muster, das wir unter Kontextsilos behandeln.
Wo MCP in den Stack gehört
Wenn es bei Context Engineering darum geht, einem Modell geregelten Kontext zu liefern, muss etwas diesen Kontext von dort, wo er geregelt wird, dorthin tragen, wo er genutzt wird. Das ist die Rolle des Model Context Protocol (MCP), eines offenen Standards, um KI-Anwendungen mit externem Kontext und externen Werkzeugen zu verbinden.
MCP zählt, weil es die beiden Hälften des Problems entkoppelt. Sie regeln den Kontext einmal, in einer Infrastruktur, die Ihnen gehört, und machen ihn über eine einzige standardisierte Verbindung verfügbar. Dann liest jeder MCP-fähige Assistent und jeder MCP-fähige Agent, ein Copilot im Warehouse, ein BI-Werkzeug, eine Eigenentwicklung oder eine Agentenplattform, aus derselben geregelten Quelle, statt eine eigene zu erfinden. MCP ist die Auslieferungsschicht, die aus einem geregelten Context Layer etwas macht, das jedes Werkzeug nutzen kann, ohne dass Sie den Kontext für jedes einzeln neu umsetzen. Das ist der Unterschied, ob Sie Kontext einmal aufbauen oder ihn in jedem Werkzeug immer wieder neu aufbauen.
Governance ist das Fundament der Kontextqualität
Alles bisher läuft auf einen Punkt zu: Kontext, den Sie nicht regeln, können Sie auch nicht gestalten. Die semantische Schicht, die Governance-Schicht und die Herkunftsschicht sind kein optionaler Feinschliff über dem Abruf; sie sind der Teil, der den Kontext belastbar macht, und genau der Teil, den ein Modell nicht selbst erzeugen kann.
Ein Modell kann ein Dokument zusammenfassen. Es kann Ihnen nicht sagen, dass dieses Dokument die freigegebene Fassung ist und nicht ein Entwurf, dass „aktiver Kunde“ in diesem Quartal abgesprungene Testkonten ausschließt, dass eine Spalte PII enthält, die maskiert werden muss, oder dass eine Kennzahl letzten Monat ausgemustert wurde. Das sind Governance-Tatsachen, von Menschen verfasst und gepflegt, und sie sind der Unterschied zwischen einer Antwort, die richtig aussieht, und einer, die richtig ist. Die Qualität des Kontexts hängt an der Qualität der Governance. Liegen Ihre Definitionen verstreut in Wikis, Tabellen und einzelnen Köpfen, erbt Ihre KI genau diese Zersplitterung, so gut das Modell auch sein mag.
Wie Dawiso den Context Layer baut
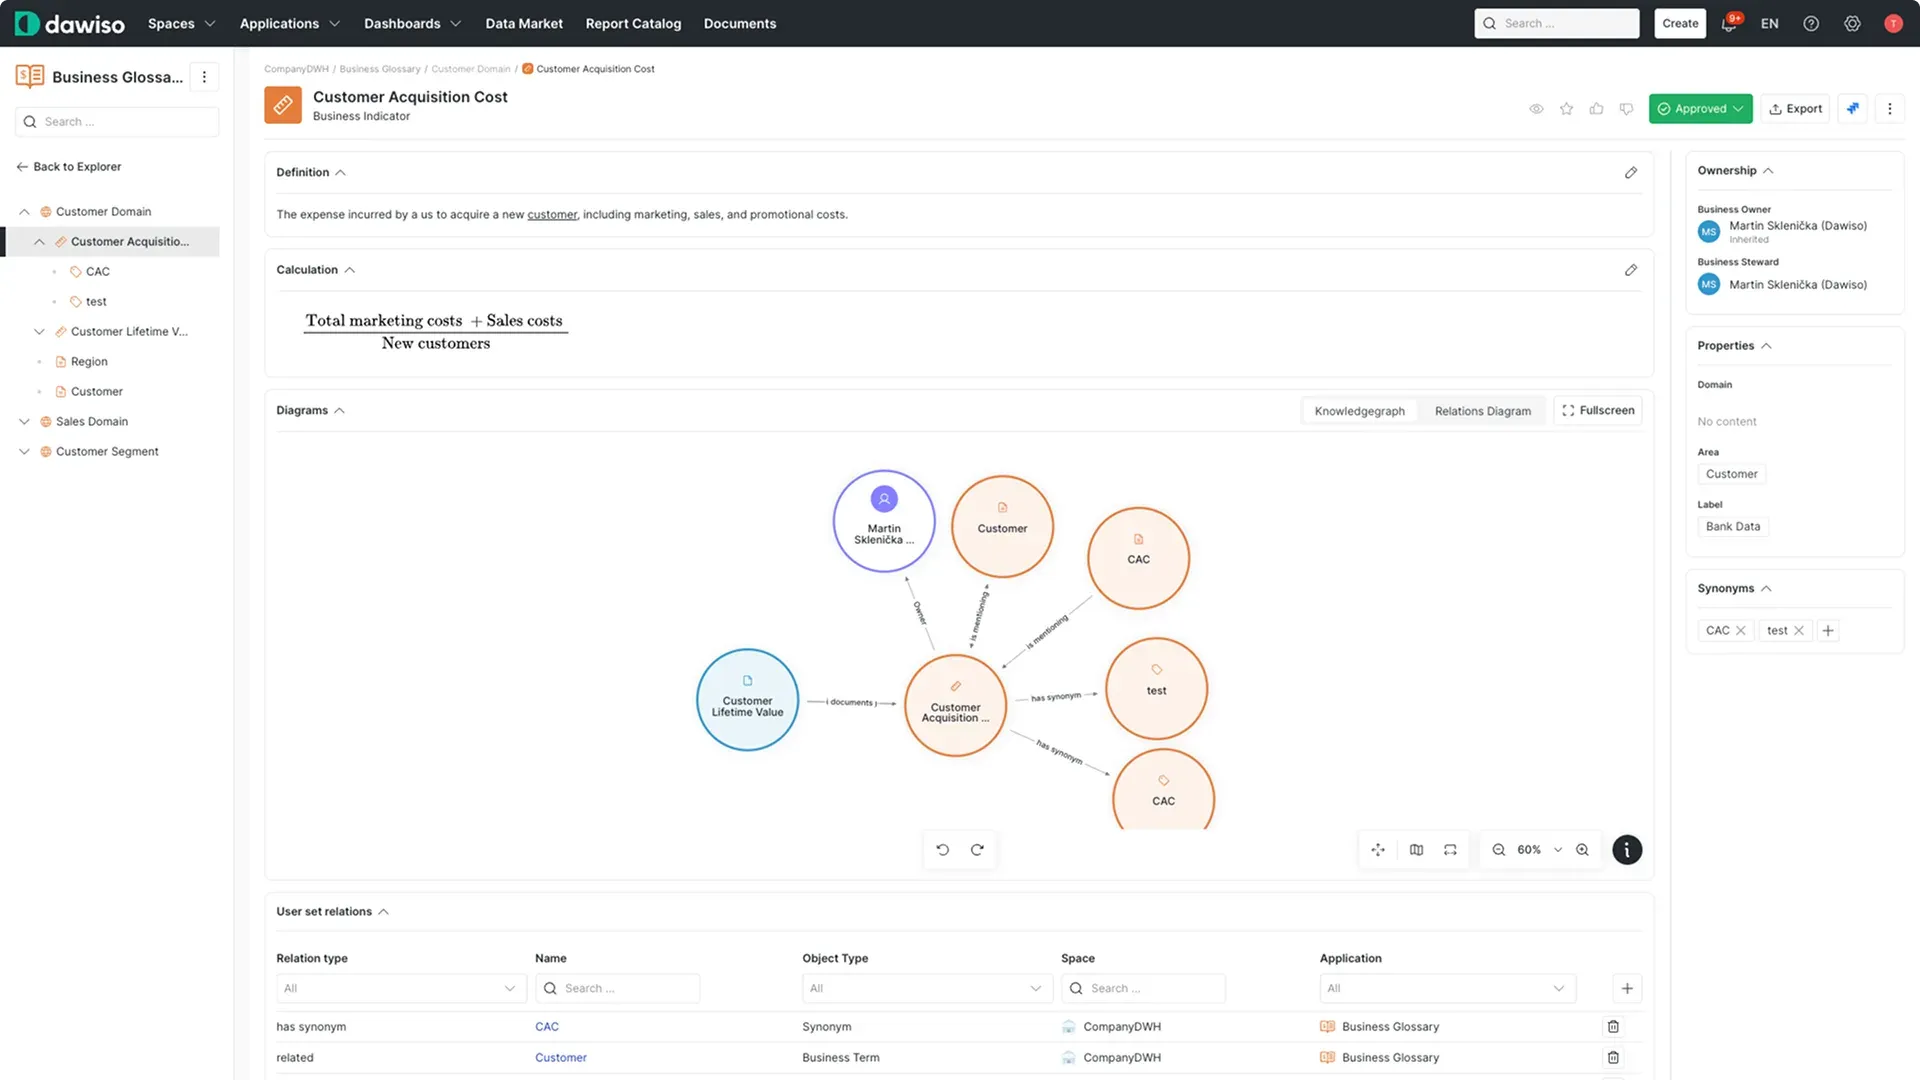
Genau dafür ist Dawiso gebaut. Es bindet mehr als 40 Plattformen an und fügt daraus ein einziges geregeltes Fundament zusammen: einen Data Catalog dessen, was es gibt, ein Business Glossary dessen, was jeder Begriff bedeutet, eine Klassifizierung dessen, was sensibel ist, und Interactive Data Lineage dessen, woher alles kommt. Dawiso AI hilft, Beschreibungen, Vorschläge zur Verantwortlichkeit und Klassifizierung zur Prüfung durch Menschen zu erzeugen, sodass sich die geregelte Schicht in Tagen statt in Quartalen aufbauen lässt.
Über den Context Layer und seinen MCP Server stellt Dawiso diesen geregelten Kontext jedem MCP-fähigen Assistenten oder Agenten bereit. Die semantische Schicht, die Governance-Schicht und die Herkunftsschicht, also die drei, die die meisten Teams überspringen, werden zu einem einzigen eigenen Bestand, aus dem jedes KI-Werkzeug liest. Ihr Kontext wird einmal gestaltet, an einer Stelle geregelt und überall genutzt, und genau darum geht es bei Context Engineering im Maßstab eines Unternehmens.
Wenn Sie so weit sind, die Schicht selbst zu bauen, führt unser Begleitartikel Schritt für Schritt hindurch: einen Context Layer für KI im Unternehmen umsetzen.
FAQ
Was ist Context Engineering in einfachen Worten?
Worin unterscheidet sich Context Engineering von Prompt Engineering?
Ist Context Engineering nur Retrieval-Augmented Generation (RAG)?
Warum löst ein größeres Kontextfenster das Problem nicht?
Wie unterstützt Dawiso Context Engineering?
In Aktion erleben
Dawiso MCP Server
Stellen Sie geregelten fachlichen Kontext jedem LLM und jedem Agenten über ein offenes Protokoll bereit.