Agentensysteme und Abfragen in natürlicher Sprache: der Wandel von KI und Daten
Die Landschaft von Künstlicher Intelligenz und Datenmanagement wandelt sich rasch, und zwei Richtungen treten dabei als bestimmend hervor. Während Systeme für Abfragen in natürlicher Sprache und Analyse im Dialog eine umwälzende Art einführten, wie Menschen mit ihren Datenplattformen umgehen, rücken nun Agentensysteme als nächste Stufe der von KI getriebenen Datenarbeit in den Mittelpunkt. Diese beiden großen Richtungen der KI zu verstehen ist entscheidend für Unternehmen, die ihre Dateninfrastruktur erneuern und den Wert ihrer Informationen ausschöpfen wollen.
Die zwei großen Richtungen der KI bei Daten verstehen
Der Wandel darin, wie Unternehmen mit ihren Daten umgehen und sie steuern, hat sich in zwei großen Richtungen der KI verfestigt. Diese Ansätze stehen für grundlegend verschiedene Auffassungen davon, welche Rolle Künstliche Intelligenz in der Datenarbeit spielt, und doch hängen beide von einem ausgefeilten Metadatenmanagement ab, um wirksam zu arbeiten.
1. Abfragen in natürlicher Sprache und „chat with my data“: die erste Welle des Umgangs mit Daten über KI
Systeme für Abfragen in natürlicher Sprache, meist als „chat with my data“ oder als Plattformen für Analyse im Dialog bekannt, traten als erste große Richtung der KI im Datenmanagement hervor. Sie erlauben es, mit Daten in ganz normaler Alltagssprache umzugehen statt über komplexe SQL-Abfragen oder technische Oberflächen. Statt Code zu schreiben oder sich durch mehrere Dashboards zu klicken, können Menschen einfach Fragen stellen wie „Wie viel habe ich in diesem Quartal verkauft?“ oder „Haben wir Daten zur Kundenbindung?“
Anbieter verwenden dafür verschiedene Begriffe, darunter Natural Language Query (NLQ) bei Plattformen wie ThoughtSpot, Tableau und Power BI. Tableau nennt diese Fähigkeit eigens „Ask Data“, während andere Anbieter von Analyse im Dialog, von KI-gestütztem Chat mit Daten oder von suchgetriebener Analyse sprechen.
Dieser Ansatz für das Zusammenspiel von KI und Daten gewann deutlich an Zugkraft, weil er den Zugang zu Daten breit öffnete. Fachbereiche ohne technischen Hintergrund konnten endlich unmittelbar mit ihren Datenplattformen arbeiten, ohne für jede Frage von Analysten oder Entwicklern abzuhängen. Systeme für Abfragen in natürlicher Sprache wirken als neue vorgelagerte Schicht, die natürliche Sprache in Datenbankabfragen übersetzt, die passenden Informationen abruft und sie verständlich darstellt.
Die Einführung von „chat with my data“ erwies sich für viele Unternehmen als vergleichsweise unkompliziert. Diese Systeme drehen sich vor allem um das Abrufen von Daten und einfache Auswertungen und übersetzen menschliche Sprache in eine Sprache, die eine Datenbank versteht. Sie lösten zwar das Problem des Zugangs, verlangten aber weiterhin, dass Menschen die Fragen formulieren und die Ergebnisse deuten.
2. Agentensysteme: die nächste Stufe im Datenmanagement mit KI
Agentensysteme stehen für die zweite und weiter fortgeschrittene Richtung der KI in der Datenarbeit. Anders als Plattformen für Analyse im Dialog, die auf Fragen der Nutzer warten, erledigen Agentensysteme von sich aus Aufgaben und ganze Abläufe eigenständig. Diese Verschiebung macht aus KI statt eines reaktiven Antwortwerkzeugs eine vorausschauende digitale Arbeitskraft, die komplexe Datenarbeit ausführen kann.
Der Unterschied zwischen den beiden großen Richtungen der KI wird an ihren Arbeitsmodellen deutlich. Während Systeme für Abfragen in natürlicher Sprache auf Fragen antworten, bekommen Agentensysteme übergeordnete Anweisungen und bestimmen dann selbst die Schritte, die nötig sind, um ganze Vorhaben abzuschließen. Ein Agentensystem bekommt womöglich die Aufgabe „Erstelle ein wöchentliches Dashboard zur Vertriebsleistung“ und bestimmt daraufhin eigenständig die nötigen Datenquellen, baut Datenpipelines, führt Umformungen durch und erzeugt die Darstellung, ohne dass ein Mensch weiter eingreift.
Große Technologieunternehmen investieren stark in Agentensysteme. Microsoft hat etwa den Fabric Data Agent entwickelt, und Snowflake hat Snowflake Intelligence vorgestellt, eine dialogorientierte KI-Anwendung, die Fachbereichen erlaubt, mit den Daten des Unternehmens in natürlicher Sprache zu arbeiten und dabei Sicherheit und Governance zu wahren. Keboola und andere Plattformen haben KI-Dateningenieure eingeführt, die Aufgaben wie das Bauen von Datenpipelines, das Steuern von Umformungen und das Erzeugen vollständiger Berichte eigenständig übernehmen.
Wie Agentensysteme die Datenarbeit verändern
Agentensysteme verändern die Natur der Datenarbeit von Grund auf, indem sie Aufgaben automatisieren, für die bisher erfahrene Dateningenieure und Analysten nötig waren. Zu verstehen, wie Agentensysteme arbeiten, zeigt, warum sie einen so bedeutenden Fortschritt in KI und Datenmanagement darstellen.
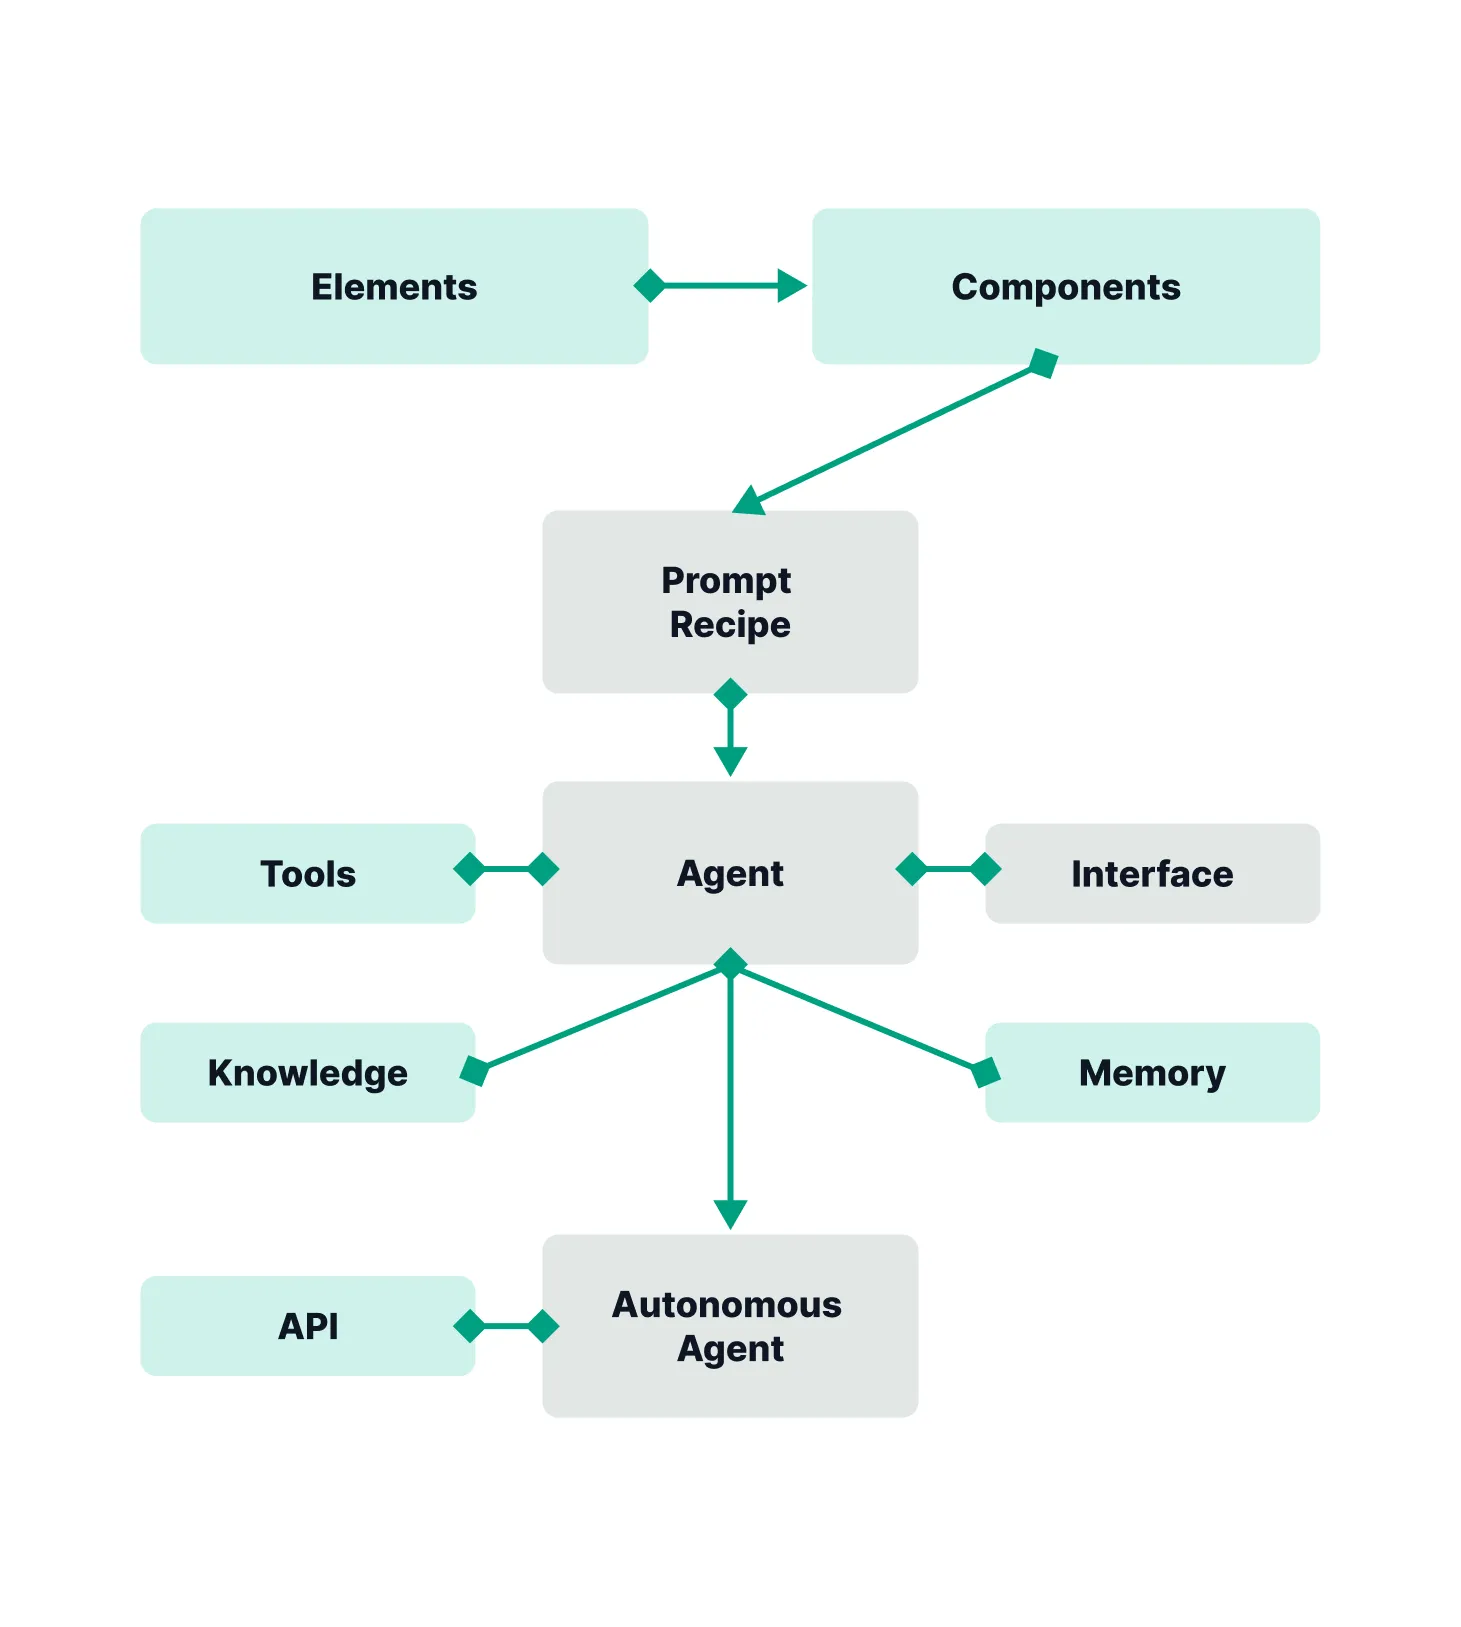
Der Ablauf von Agentensystemen im Data Engineering
Das Arbeitsmodell von Agentensystemen ähnelt der Zusammenarbeit menschlicher Teams im Data Engineering. Ein Dateningenieur verbringt klassisch Stunden oder Tage damit, eine Datenpipeline von Hand zu bauen, die Logik der Umformung zu schreiben, den Ablauf zu testen und Darstellungen zu erzeugen. Agentensysteme erledigen dieselben Aufgaben in Minuten und folgen dabei einem strukturierten Ablauf, der mehrere spezialisierte Agenten nutzt.
Stellen Sie sich einen typischen Fall vor, in dem ein Dateningenieur mehrere Agenten startet, um ein umfassendes Datenvorhaben abzuschließen. Der erste Agent bekommt die übergeordnete Anweisung: „Ich muss diese Vertriebsdaten aus unserem CRM in unser Analyse-Warehouse bringen.“ Dieser Agent versteht die Anforderung und bestimmt Quell- und Zielsystem.
Ein zweiter Agent bekommt dann die Aufgabe, die eigentliche Datenpipeline zu bauen. Er entwirft das Auslesen, bestimmt die nötigen Umformungen wie das Bereinigen leerer Werte und das Vereinheitlichen von Formaten und richtet das Laden ein, um die verarbeiteten Daten am Zielort abzulegen. Das Agentensystem schreibt den Code selbst, stellt die Verbindungen her und setzt die Fehlerbehandlung um.
Ein dritter Agent nimmt dann womöglich die umgeformten Daten und erzeugt einen Bericht in Power BI, der die von den Beteiligten gewünschten Kennzahlen zeigt. Dieser Agent kennt bewährte Vorgehensweisen der Darstellung, wählt passende Diagrammtypen und richtet das Dashboard für ein gutes Nutzererlebnis ein. All das geschieht mit kaum mehr menschlichem Zutun als der anfänglichen Aufgabenstellung.
Die Rolle der Metadaten bei Abfragen in natürlicher Sprache und bei Agentensystemen
Sowohl Plattformen für Analyse im Dialog als auch Agentensysteme hängen entscheidend von umfassenden Metadaten und einem Semantic Layer ab, um wirksam zu arbeiten. Metadaten sind das Fundament, das diesen KI-Systemen erlaubt zu verstehen, welche Daten es gibt, wo sie liegen, wie sie mit anderen Daten zusammenhängen und welche Umformungen angemessen sind.
Für Agentensysteme sind Metadaten sogar noch wichtiger als für Systeme mit Abfragen in natürlicher Sprache. Wenn ein Agent eine Datenpipeline bauen soll, muss er über Metadaten die Datenschemata verstehen, Beziehungen zwischen Tabellen erkennen, Mängel der Datenqualität bemerken und die passende Logik der Umformung bestimmen. Ohne reiche Metadaten könnten Agentensysteme keine fundierten Entscheidungen über Datenarbeit treffen.
Werkzeuge wie Dawiso stützen beide großen Richtungen der KI, indem sie die Metadateninfrastruktur liefern, die diese Systeme brauchen. Ob ein Unternehmen Abfragen in natürlicher Sprache einführt oder weiter fortgeschrittene Agentensysteme, ein belastbares Metadatenmanagement erlaubt der KI, die Datenlandschaft zu verstehen und wirksam zu arbeiten.
Abfragen in natürlicher Sprache und Agentensysteme: die beiden Richtungen im Vergleich
Beide Ansätze stehen für wichtige Richtungen der KI im Datenmanagement, dienen aber verschiedenen Zwecken und bieten verschiedene Vorteile. Unternehmen müssen diese Unterschiede kennen, um fundiert über ihre KI-Strategie zu entscheiden.
Aufwand und Fragen der Einführung
Systeme für Abfragen in natürlicher Sprache lassen sich in der Regel leichter einführen und verlangen weniger ausgefeilte KI-Fähigkeiten: vor allem Sprachverarbeitung, um Fragen der Nutzer zu deuten, die Erzeugung von Abfragen, um Daten abzurufen, und eine Darstellungslogik, um Ergebnisse aufzubereiten. Die technische Einstiegshürde ist verhältnismäßig niedrig, was erklärt, warum sich „chat with my data“ so rasch verbreitet hat.
Agentensysteme verlangen deutlich fortgeschrittenere KI-Fähigkeiten. Sie brauchen Schlussfolgern, um komplexe Aufgaben in Schritte zu zerlegen, Entscheidungslogik, um passende Wege zu wählen, und Anbindungsfähigkeiten, um mit mehreren Datenwerkzeugen und Plattformen zu arbeiten. Ihre Einführung ist aufwendiger, doch der mögliche Nutzen ist entsprechend größer.
Eigenständigkeit und menschliche Beteiligung
Der Grad der Eigenständigkeit ist ein grundlegender Unterschied zwischen diesen beiden großen Richtungen der KI. Plattformen für Analyse im Dialog bleiben auf fortlaufende menschliche Eingaben angewiesen und verlangen, dass Menschen Fragen formulieren und Antworten deuten. Diese Systeme unterstützen menschliche Entscheidungen, ersetzen aber weder Analyse noch Handeln.
Agentensysteme sind darauf angelegt, Teile eines Ablaufs zu automatisieren, doch ihr Grad an Eigenständigkeit kann sich unterscheiden. In vielen Fällen brauchen sie an wichtigen Stellen weiterhin menschliche Freigabe oder Eingaben, um Richtigkeit und Compliance zu sichern. Statt menschliche Aufsicht vollständig zu ersetzen, wirken sie als kluge Assistenzen, die Routine straffen und Datenteams helfen, sich auf Strategie und Entscheidungen zu richten.
Anwendungsfälle
Systeme für Abfragen in natürlicher Sprache sind stark bei spontanen Auswertungen, beim Erkunden von Daten und bei schnellen Antworten auf geschäftliche Fragen. Sie dienen Fachbereichen, die gelegentlich Daten brauchen und einfache Auswertungen fahren. Sie öffnen den Zugang zu Daten im ganzen Unternehmen, weil alle in Alltagssprache fragen können.
Agentensysteme passen besser zu wiederkehrender Datenarbeit, zu komplexen mehrstufigen Abläufen und zu Lagen, die eine Anbindung über mehrere Datenplattformen hinweg verlangen. Sie wirken als virtuelle Dateningenieure, die erhebliche Teile des Aufbaus und der Pflege von Datenpipelines übernehmen. Besonders wertvoll sind sie für Unternehmen mit viel Datenarbeit und wenig Kapazität im Data Engineering.
Stand und Zukunft der Agentensysteme
Agentensysteme sind der Schwerpunkt der KI von heute und der nahen Zukunft im Datenmanagement. Zu verstehen, wo diese Technik heute steht und wohin sie geht, hilft Unternehmen, sich auf die Entwicklung einzustellen.
Wie die Einführung von Agentensystemen verläuft
Die Verschiebung hin zu Agentensystemen spiegelt breitere Entwicklungen der KI wider: Unternehmen, die Abfragen in natürlicher Sprache wirksam einführen, sehen eine deutlich kürzere Time-to-Insight und mehr aktive Datennutzer. Nach der anfänglichen Begeisterung für „chat with my data“ und Analyse im Dialog merkten Unternehmen, dass diese Werkzeuge zwar den Zugang verbesserten, die Last der Datenteams aber nicht grundlegend verringerten. Fragen mussten weiterhin beantwortet, Pipelines weiterhin gebaut und Berichte weiterhin erstellt werden.
Agentensysteme begegnen dieser Grenze, indem sie die Arbeit tatsächlich erledigen, statt nur den Zugang zu Informationen zu erleichtern. Das erklärt, warum Agentensysteme in diesem Jahr zum Brennpunkt von KI und Daten geworden sind und warum erwartet wird, dass sie auch im kommenden Jahr die Diskussion bestimmen.
Große Datenplattformen wetteifern darum, Agentenfähigkeiten einzubauen: Microsoft hat die schlussfolgernden Agenten Researcher und Analyst in Microsoft 365 Copilot vorgestellt, und Snowflake hat Intelligence für dialogorientierte KI-Anwendungen gestartet. Diese Angebote reifen noch, doch frühe Umsetzungen zeigen beeindruckende Fähigkeiten.
Hürden und Fragen bei Agentensystemen
Trotz ihres Versprechens stehen Agentensysteme vor mehreren Hürden, die Unternehmen bedenken müssen. Vertrauen und Überprüfbarkeit bleiben erhebliche Sorgen. Baut ein menschlicher Dateningenieur eine Pipeline, können andere im Team Code und Logik prüfen. Baut ein Agentensystem dieselbe Pipeline eigenständig, brauchen Unternehmen Wege, die Arbeit zu prüfen und die Einhaltung von Qualitätsstandards zu sichern.
Data Governance wird mit Agentensystemen komplexer. Diese Systeme brauchen passende Berechtigungen, um auf sensible Daten zuzugreifen, die Dateninfrastruktur zu ändern und neue Pipelines auszurollen. Unternehmen müssen Governance-Rahmen entwickeln, die Agentensystemen wirksames Arbeiten erlauben und zugleich Sicherheit und Compliance wahren.
Die Lernkurve im Umgang mit Agentensystemen unterscheidet sich von der klassischer Datenwerkzeuge. Datenteams müssen lernen, Agentensysteme wirksam zu beauftragen und zu beaufsichtigen, ihnen passenden Kontext für Aufgaben zu geben und ihre Ergebnisse in die breitere Datenstrategie einzubinden. Das verschiebt die Fähigkeiten, die Fachleute für Daten brauchen.
Wie Abfragen in natürlicher Sprache und Agentensysteme zusammenwachsen
Auch wenn diese Darstellung „chat with my data“ und Agentensysteme als getrennte Richtungen der KI behandelt hat, ist die Wirklichkeit vielschichtiger. Die Ansätze beginnen zusammenzuwachsen, während die Technik voranschreitet.
Gemischte Ansätze für KI und Daten
Manche neuen Plattformen verbinden Elemente beider Welten: Menschen beginnen mit einer Frage im Dialog, und das System antwortet nicht nur darauf, sondern bietet auch an, eine Datenpipeline zu bauen oder ein Dashboard zu erzeugen. Dieser gemischte Ansatz verbindet die Zugänglichkeit von Abfragen in natürlicher Sprache mit dem Produktivitätsgewinn von Agentensystemen.
Der Fabric Data Agent von Microsoft und Snowflake Intelligence etwa vereinen Aspekte beider Ansätze und arbeiten als Agenten, die Daten eigenständig finden und verarbeiten, dabei aber auch Oberflächen für den Dialog mitbringen. Diese Beweglichkeit erlaubt verschiedenen Menschen, mit der KI so umzugehen, wie es zu ihrem Bedarf und ihrer Vertrautheit passt.
Dass die beiden großen Richtungen der KI im Datenmanagement zusammenwachsen, legt nahe, dass es künftig nicht darum geht, sich zwischen ihnen zu entscheiden, sondern Plattformen einzuführen, die beide Umgangsformen tragen. Unternehmen profitieren davon, Abfragen in natürlicher Sprache für spontane Fragen zu haben und zugleich Agentenfähigkeiten für den laufenden Betrieb zu nutzen.
Fazit: beide Richtungen der KI bei Daten annehmen
Die Entwicklung der KI im Datenmanagement hat zwei große Richtungen hervorgebracht, die Unternehmen verstehen und einordnen müssen. Systeme für Abfragen in natürlicher Sprache und Analyse im Dialog brachten sprachliche Oberflächen und besseren Zugang zu Datenplattformen und öffneten den Datenzugang im ganzen Unternehmen. Sie bleiben wertvoll für spontane Auswertungen und das Erkunden und bieten einen nutzerfreundlichen Weg, in Alltagssprache mit Daten umzugehen.
Agentensysteme stehen für die nächste Stufe und gehen über das Beantworten von Fragen hinaus zum tatsächlichen Erledigen von Arbeit. Sie können Datenpipelines bauen, Umformungen steuern, Berichte erzeugen und komplexe Abläufe mit kaum menschlichem Zutun abschließen. Während Technologieunternehmen wie Microsoft schlussfolgernde Agenten einführen und andere Anbieter stark in Agentenfähigkeiten investieren, ist klar, dass Agentensysteme die Diskussion um KI und Datenmanagement in den kommenden Jahren bestimmen werden.
Sowohl „chat with my data“ als auch Agentensysteme brauchen eine starke Metadateninfrastruktur und einen Semantic Layer, um wirksam zu arbeiten. Unternehmen, die dieses Fundament bauen, stellen sich für beide Ansätze gut auf. Werkzeuge wie Dawiso stützen beide großen Richtungen der KI, indem sie das Metadatenmanagement liefern, das diese Systeme brauchen.
Die Zukunft dürfte nicht darin liegen, sich zwischen diesen beiden großen Richtungen der KI zu entscheiden, sondern Lösungen einzuführen, die Abfragen in natürlicher Sprache und Agentenfähigkeiten zugleich tragen. Unternehmen profitieren davon, Oberflächen für Analyse im Dialog zum Erkunden und Fragen zu haben und zugleich Agentensysteme für Automatisierung und Effizienz zu nutzen. Am erfolgreichsten werden jene Datenorganisationen sein, die beide Ansätze durchdacht verbinden und jeden dort einsetzen, wo er den größten Nutzen bringt.
Während Agentensysteme reifen und sich breiter durchsetzen, werden sie die Arbeit von Datenteams verändern. Statt menschliches Können zu ersetzen, werden sie es ergänzen, Routineaufgaben übernehmen und Fachleuten für Daten erlauben, sich auf Strategie, Neuerung und schwierige Probleme zu richten. Unternehmen, die sich jetzt darauf einstellen, indem sie in Metadatenmanagement investieren, Programme zur Datenqualität aufbauen und die Fähigkeiten ihrer Teams entwickeln, sind für eine von KI getriebene Datenzukunft am besten aufgestellt.
Der Weg von Abfragen in natürlicher Sprache und Analyse im Dialog zu ausgefeilten Agentensystemen ist eine grundlegende Verschiebung im Verhältnis von KI und Datenarbeit. Unternehmen, die beide großen Richtungen der KI verstehen und diese Techniken strategisch einführen, gewinnen deutliche Wettbewerbsvorteile durch schnellere Erkenntnisse, effizientere Abläufe und bessere datengestützte Entscheidungen.