Data Lineage: Techniken und Methoden der Extraktion
Unternehmen haben ausgedehnte Dateninfrastrukturen gebaut, um ihre stetig wachsenden Datenmengen zu erfassen und zu verarbeiten. Doch je mehr Daten gespeichert werden, desto unklarer werden die Wege, auf denen wertvolle Informationen ins Geschäft gelangen, und desto weniger verlässlich werden die Auswertungen am Ende. Umso wichtiger ist es, den Weg Ihrer Daten zu kennen. Sie fragen sich, wie Data Lineage entsteht? Woher wir wissen, aus welcher Quelle die Daten stammen und welche Umformungen sie durchlaufen haben? Dann lesen Sie weiter.
Wir haben Data Lineage in diesem Beitrag bereits ausführlich behandelt, sehen wir sie uns nun aus technischer Sicht an.
Was Data Lineage ist und wie sie entsteht
Data Lineage verfolgt planmäßig den Weg der Daten von ihrem Ursprung bis zu ihrem Ziel. Sie gibt einen umfassenden Blick auf Umformungen und Abhängigkeiten und erlaubt Unternehmen, die Datenqualität zu heben, Abläufe zu straffen und aufsichtsrechtliche Compliance zu sichern.
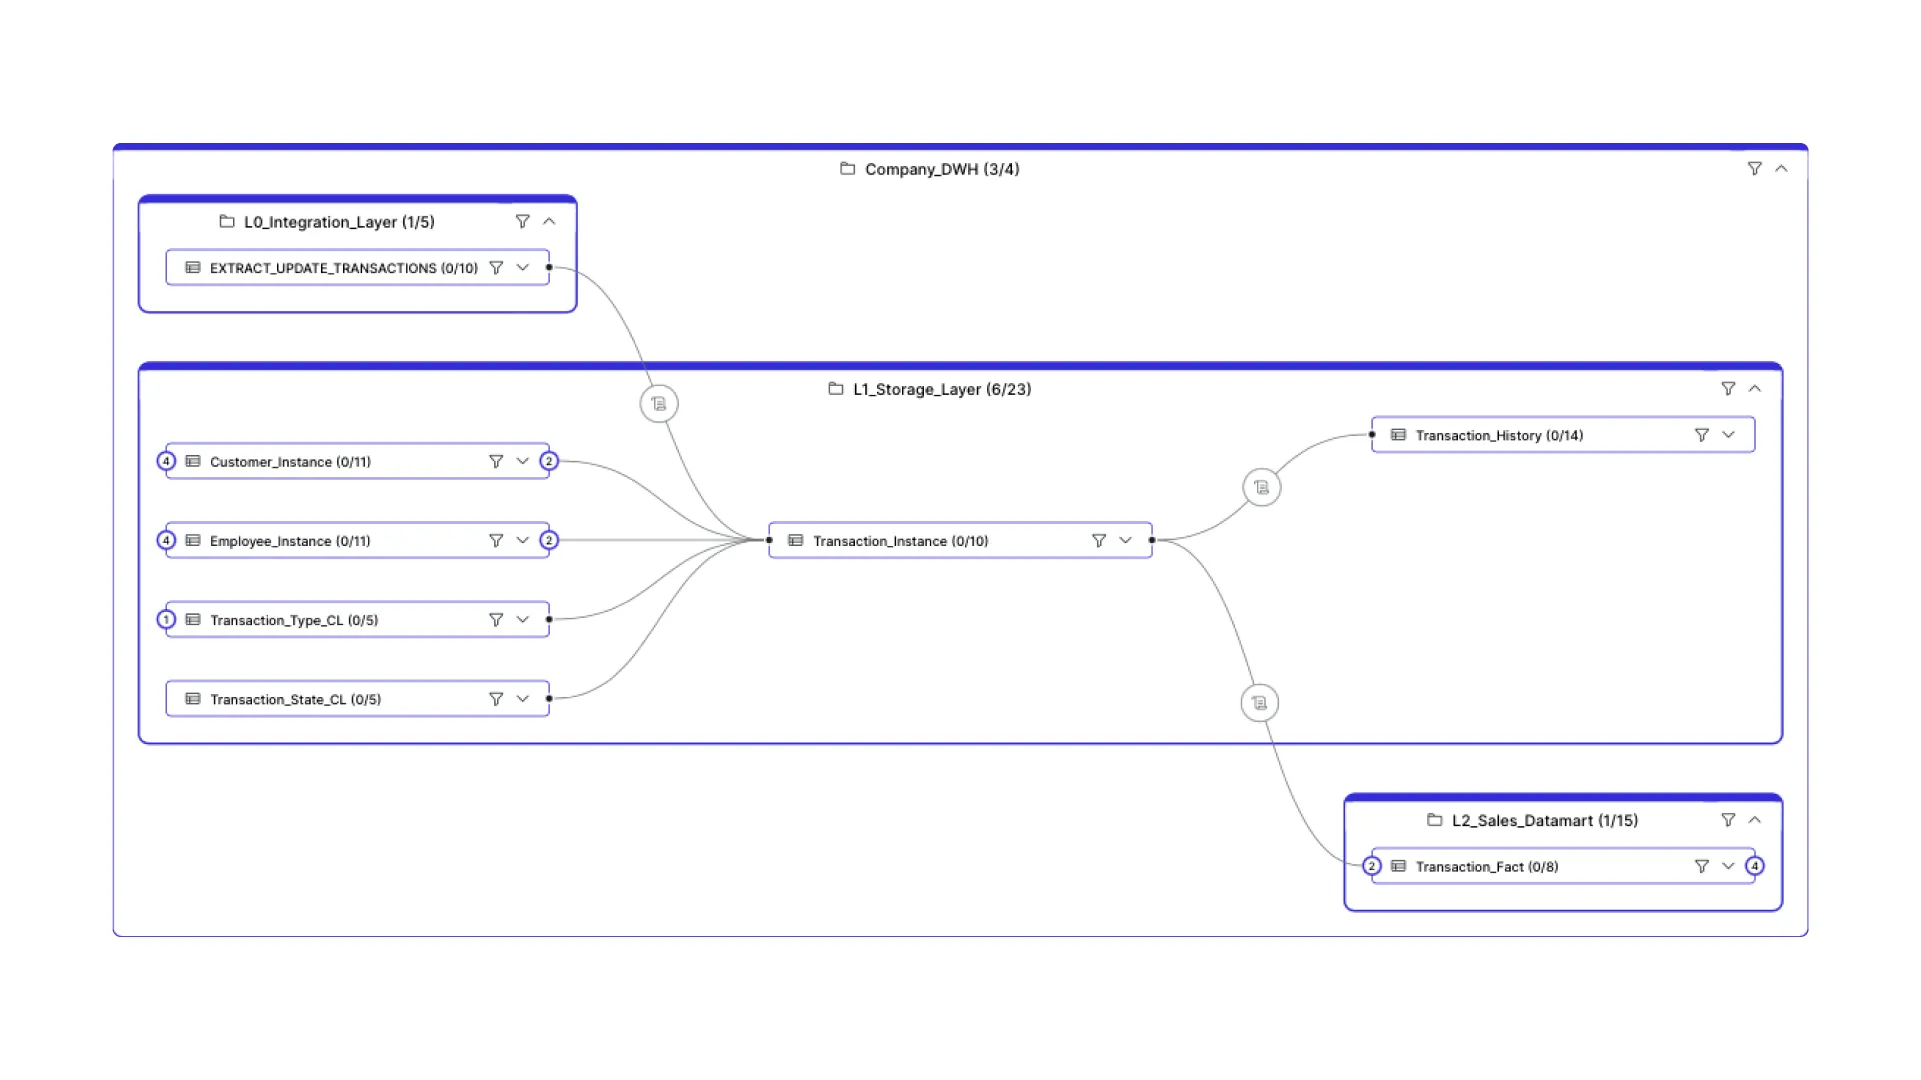
Woher kommt Data Lineage, und was müssen Dateningenieure tun, um diese Änderungen zu verfolgen?
Data Lineage lässt sich nicht allein daraus bauen, dass Metadaten vorliegen. Dawiso als Plattform für Metadaten liest die gesamte Datenbank aus und hat dann alle Tabellen, Spalten und so weiter vorliegen, doch darüber lässt sich keine Lineage zeichnen. Selbst wenn Sie alle Objekte haben, die in einer bestimmten Lineage vorkommen sollen, wissen Sie nie, wie sie zusammenhängen. Warum? Weil Lineage zeigt, wie die Daten fließen, und das Auslesen einer Datenbank nur eine statische Momentaufnahme liefert. Meist liegt auch Code vor, der etwas über die verarbeitenden Prozeduren verrät. Aber auch dann ist dieser Code nicht geparst.
Die Grundbestandteile von Data Lineage
Damit sich Data Lineage wirksam erfassen und steuern lässt, sind zwei Dinge wesentlich:
- Datenobjekte: Gebilde, die Daten halten, etwa Tabellen, Spalten, Dateien oder Datenströme. Datenobjekte sind die Bausteine der Lineage.
- Lineage-Logik: Dieser Teil beschreibt die Beziehungen und Umformungen zwischen den Datenobjekten. Er hält fest, wie Daten von einem Objekt zum nächsten fließen und welche Prozesse dabei beteiligt sind.
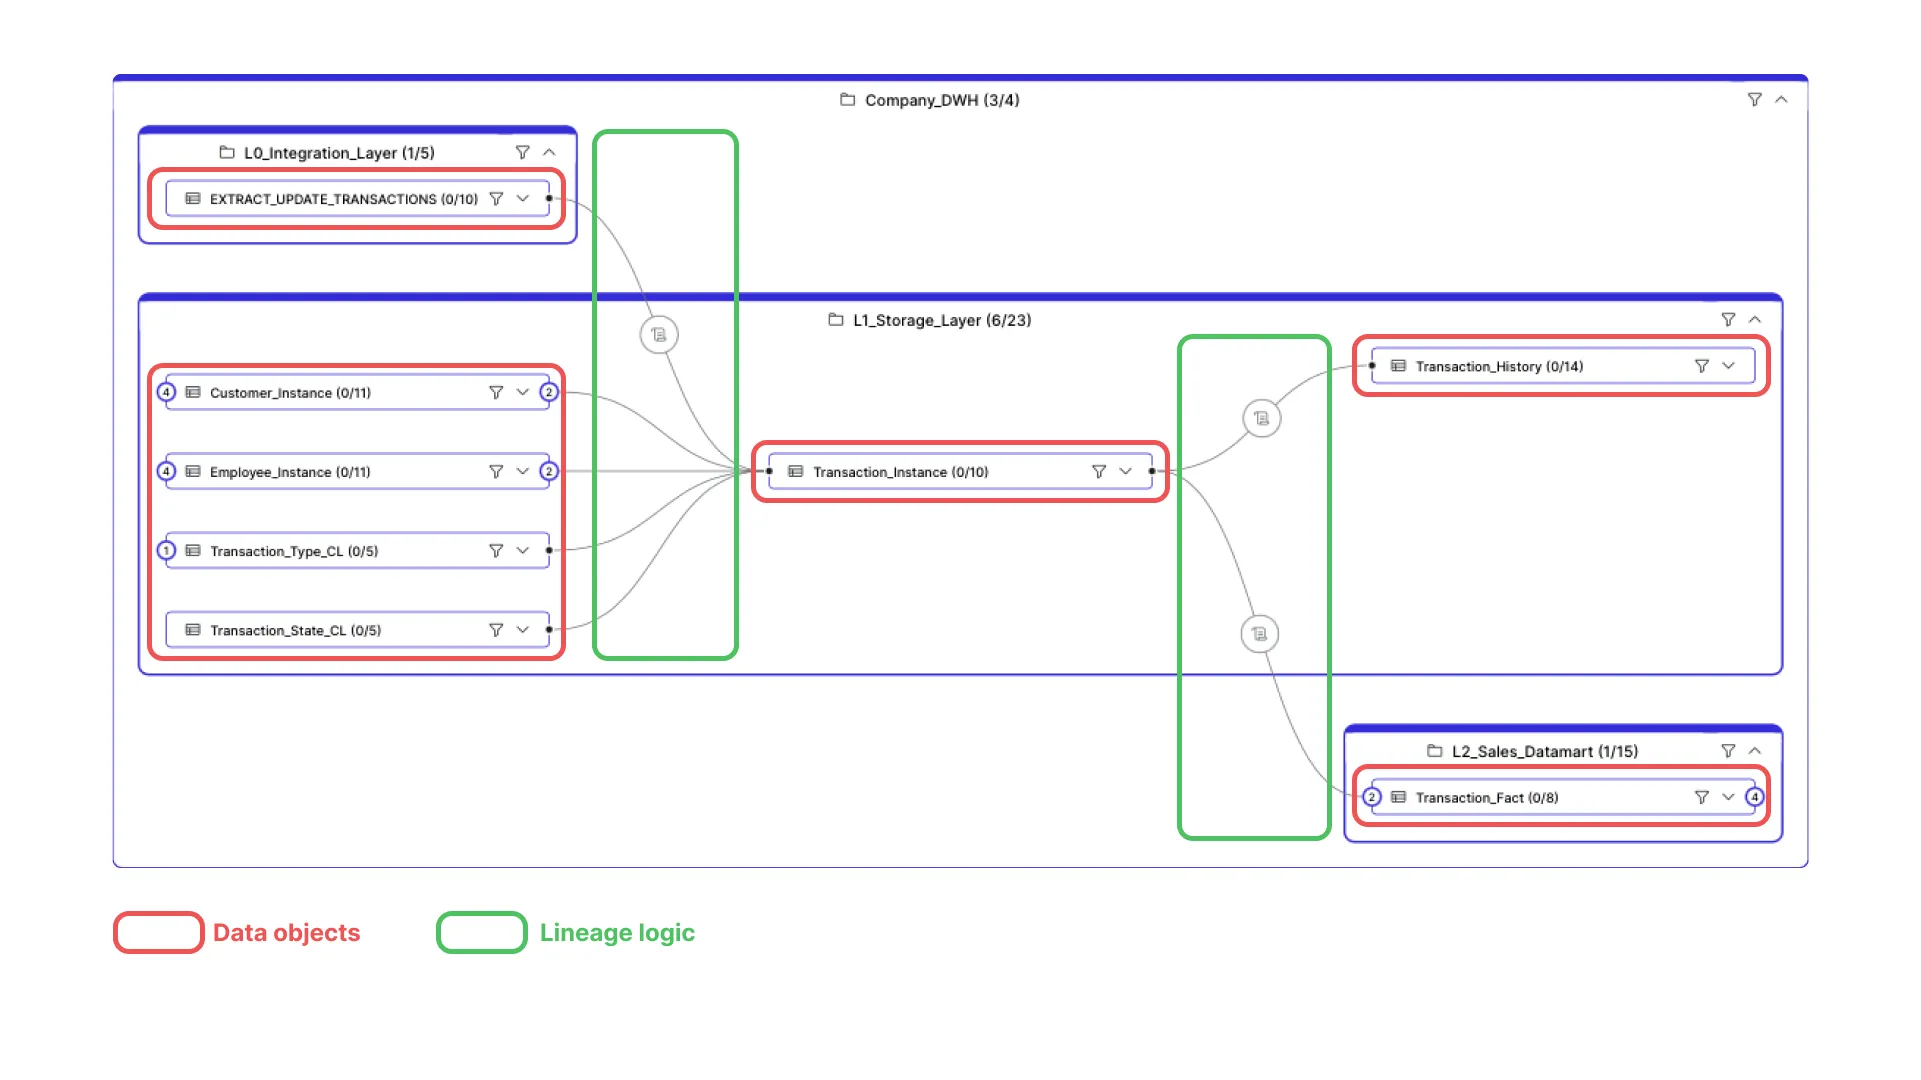
Methoden der Extraktion von Data Lineage
Wie wir wissen, besteht Data Lineage im Kern aus zwei Teilen: den Datenobjekten selbst und der Logik, die sie verbindet. Die Datenobjekte bekommen wir über das Auslesen (Metadaten). Bleibt, die Logik hinzuzunehmen. Es gibt vier Wege, an Angaben über die Herkunft zu kommen. Die ersten beiden betreffen ETL. ETL lässt sich entweder in Werkzeugen wie Keboola bauen oder von Dateningenieuren im Code schreiben.
1. Lineage aus der Plattform
Die erste Möglichkeit ist ein System, das diese Logik schon mitbringt. Ein Beispiel für solche Software ist Keboola, das seine Lineage direkt an Dawiso liefern kann. Daraus bekommen wir die Logik zwischen Tabellen, Spalten und so weiter, also sowohl die vorhandenen Datenobjekte als auch die Logik ihrer Verbindung. Die Anbindung ist leicht, und wir können das Ganze in unsere Plattform für Metadaten übertragen. Dawiso ist der erste Technologiepartner von Keboola, der die Darstellung der Data Lineage von Keboola liefert. Das ist der genaueste und einfachste Weg, an die nötigen Angaben für die Darstellung von Data Lineage zu kommen.
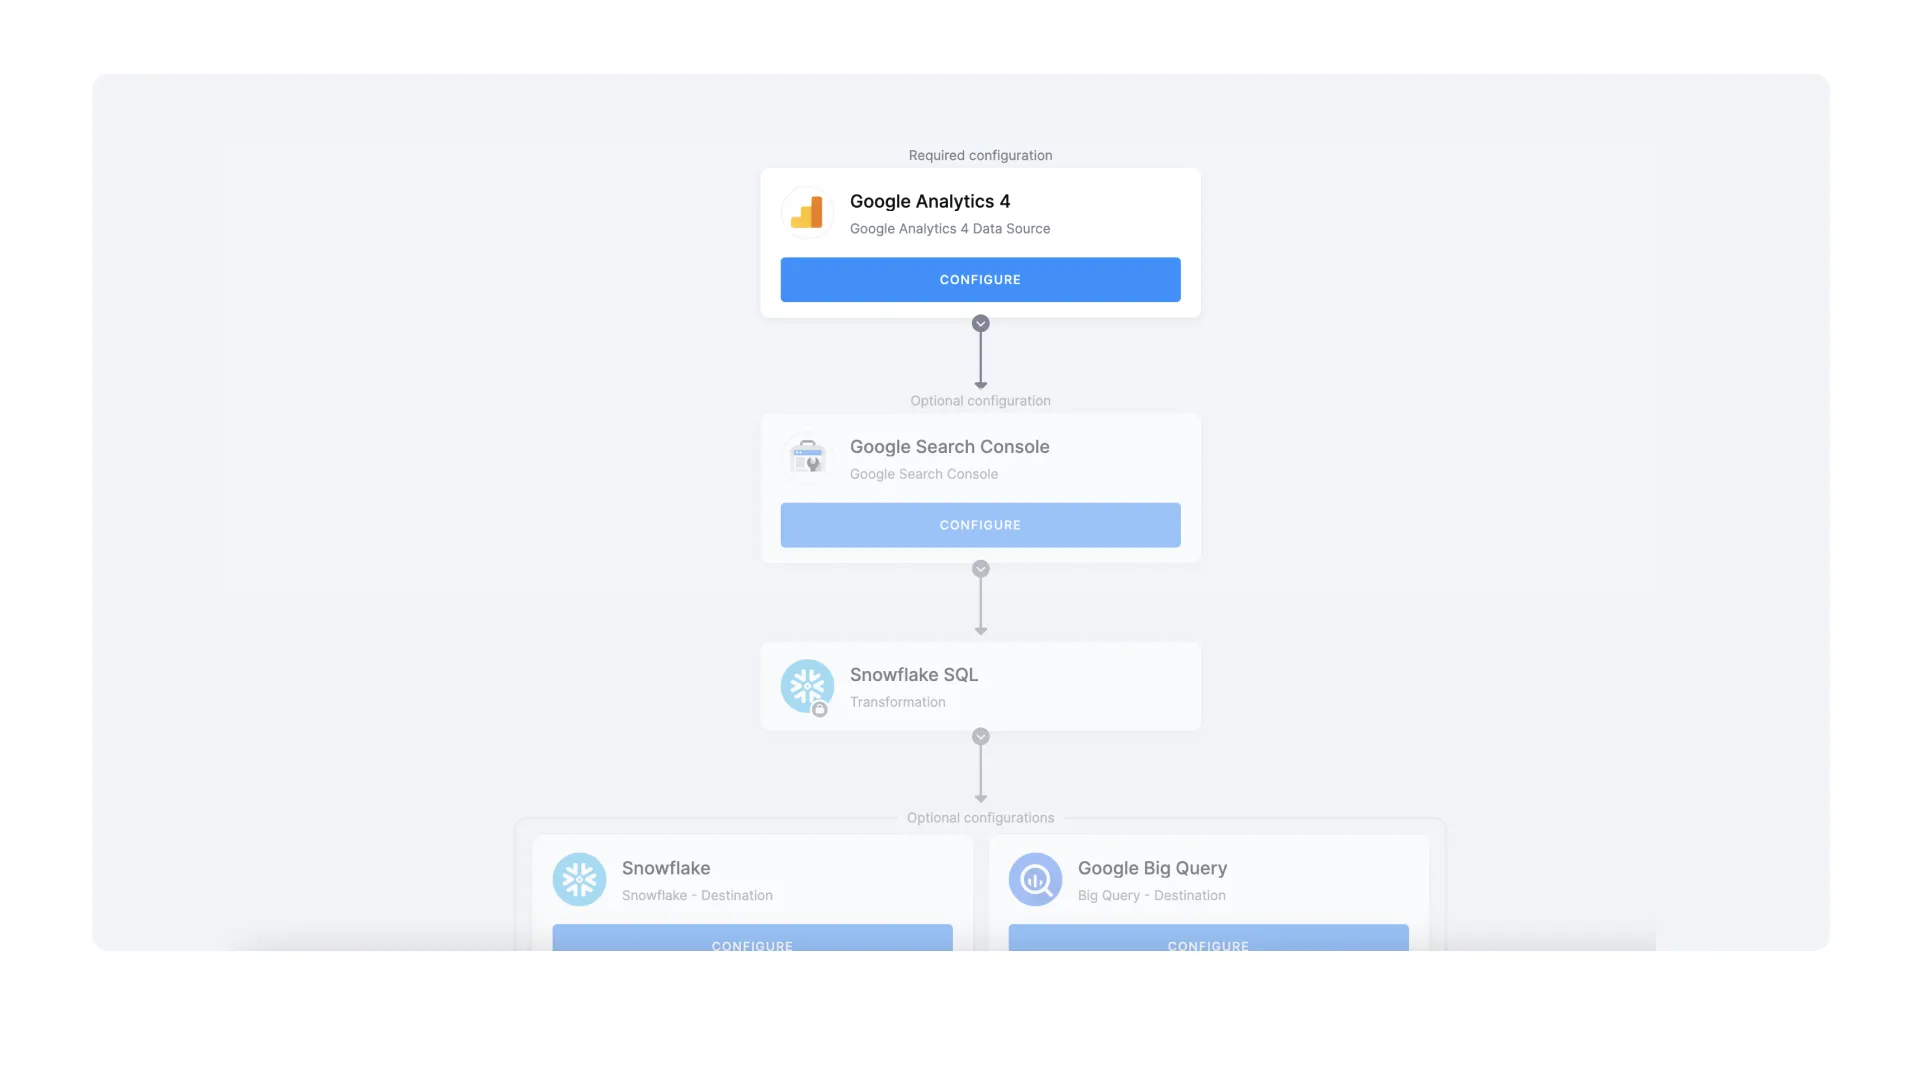
Ein Beispiel dazu. SSIS (SQL Server Integration Services) ist ein ETL-Werkzeug direkt von Microsoft, entwickelt für Microsoft-SQL-Datenbanken. Beide arbeiten gut zusammen. Das Bild zeigt die geladenen Quelldaten (Tabellen und Spalten), die dann umgeformt und anschließend in einer anderen Datenbank abgelegt werden. Das ist ETL, nur wird es nicht im Code geschrieben, sondern im Frontend gebaut, also in einer grafischen Oberfläche, ähnlich wie bei Keboola. In der Praxis sieht das Bauen dieser Logik genau so aus wie im Bild.
Diese manuelle Datenverarbeitung ist der erste Weg, ETL zu bauen.
2. Entwicklungsframework
Entwicklungsframeworks wie dbt geben einen geordneten Weg vor, Datenpipelines zu bauen und zu steuern. Solche Frameworks bringen oft Funktionen mit, die das Verfolgen von Data Lineage erleichtern, doch Detailtiefe und Anbindung können sich unterscheiden.
Über die Anbindung an dbt kann Dawiso wertvolle Angaben über Umformungen, Abhängigkeiten und den Fluss der Daten innerhalb der Pipeline ziehen. Dieser Weg ist zwar aufwendiger als die Angaben direkt aus der Plattform, weil ein System eines Dritten nötig ist, aber er bleibt sehr genau.
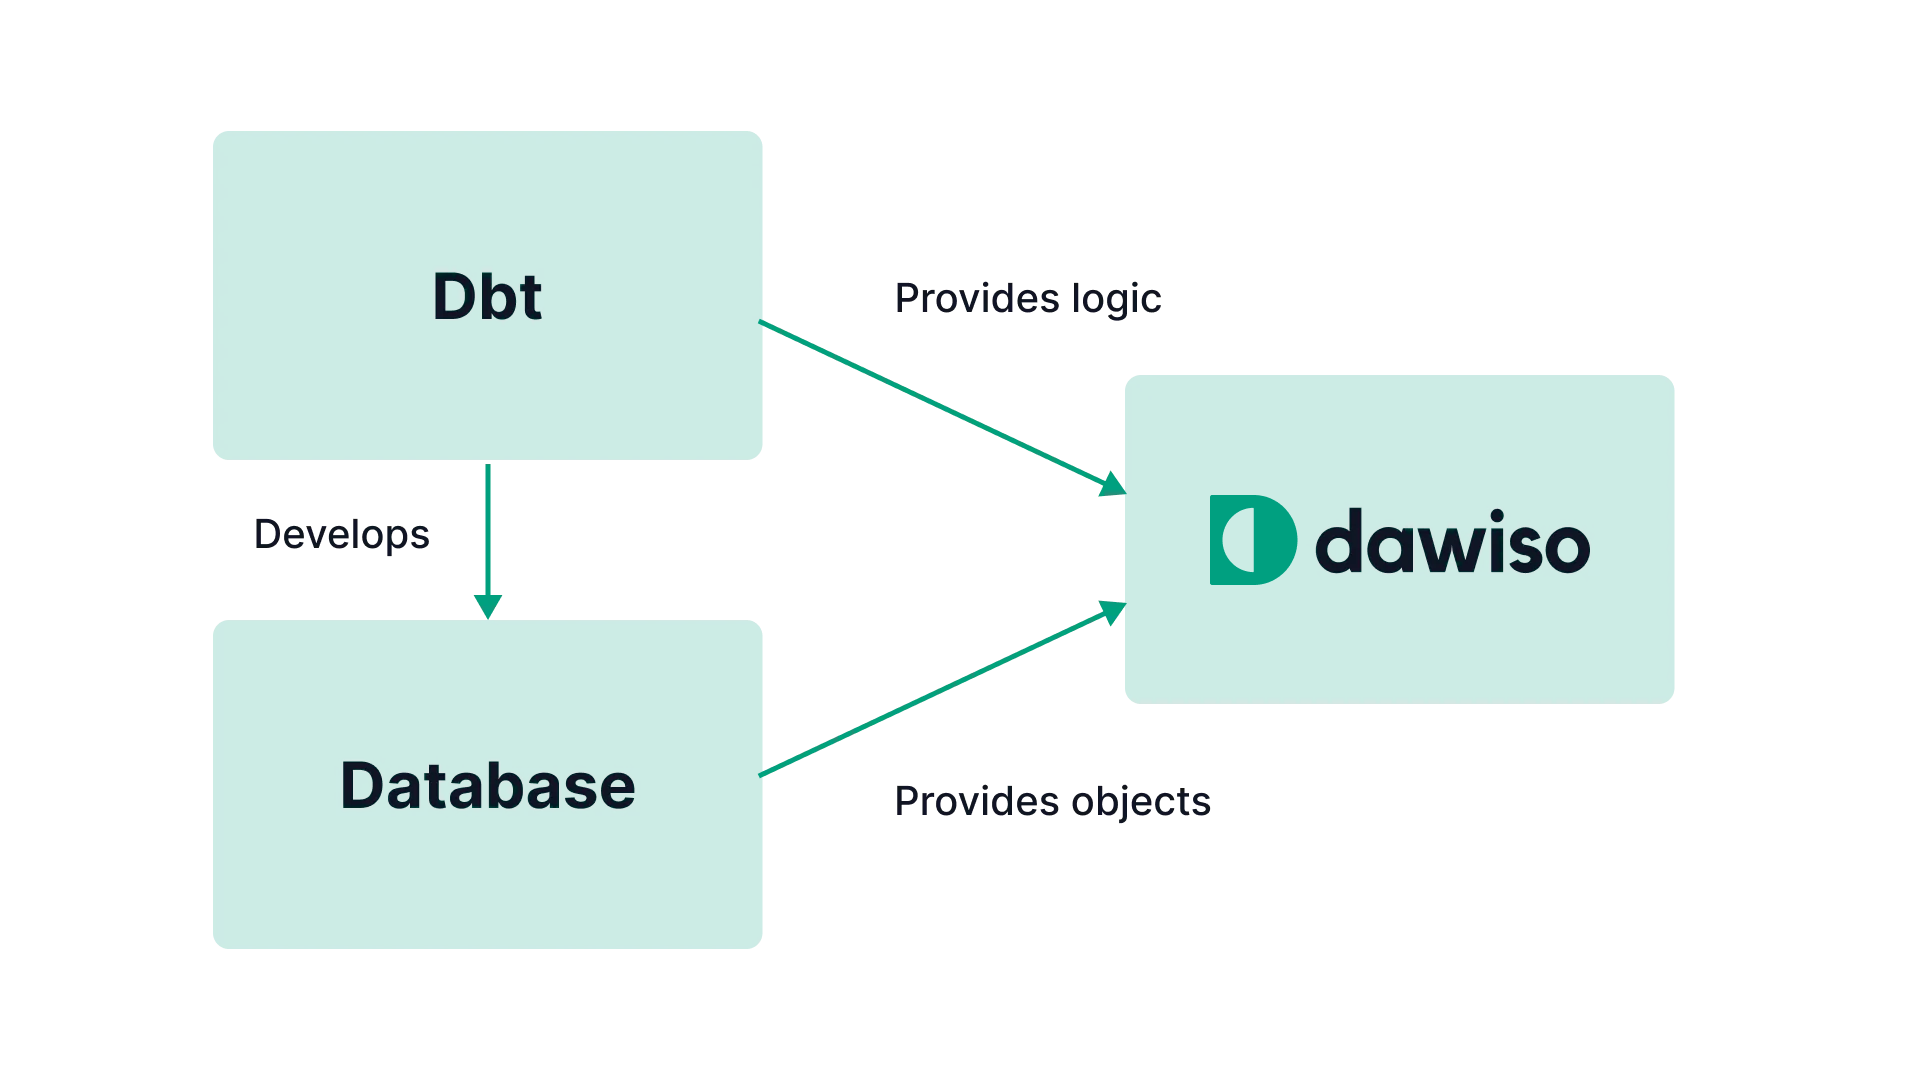
Auch wenn ein Werkzeug eines Dritten nötig ist, hat der Weg über das Framework zur Data Lineage mehrere Vorzüge. Er liefert ein feineres und umfassenderes Bild der Umformungen, weil er in die Feinheiten des Codes und der Logik im Entwicklungsframework hineinsehen kann. Diese Detailtiefe kann für Aufgaben wie Auswirkungsanalyse, Fehlersuche und Berichte zur Compliance entscheidend sein.
In manchen Fällen sind zusätzliche Werkzeuge oder Einstellungen nötig, um die Lineage-Möglichkeiten des Frameworks voll zu nutzen.
3. Lineage über Code-Parsing
Ein dritter Weg zu Angaben über Umformungen ist die Analyse des Codes, manchmal Code-Parsing genannt. Das hilft vor allem, wenn diese Umformungen unmittelbar in der Datenbank umgesetzt sind, etwa in Oracle. Fehlen einer Entwicklungsumgebung die Werkzeuge zum automatischen Erfassen von Lineage und bietet die zugrunde liegende Technik keine Lineage-APIs, lässt sich SQL-Code parsen, um die Einzelheiten der Umformungen herauszuziehen. Dieser Weg ist der ausgefeilteste und zugleich der aufwendigste Zugang zu Data Lineage. Er analysiert den zugrunde liegenden Code automatisch, um zu verstehen, wie Daten verarbeitet werden. Indem er diese Prozesse rückwärts erschließt, ergibt sich ein vollständiges Bild der Umformungen von Anfang bis Ende.
Beim Auslesen einer Datenbank treffen wir meist auf diese Grundobjekte: Tabellen, Sichten, Prozeduren und Funktionen. Tabellen und Sichten enthalten die eigentlichen Daten, Prozeduren und Funktionen sind der Code, der damit arbeitet. Prozeduren sind im Grunde gespeicherte Skripte, die ETL-Prozesse (Extract, Transform, Load) ausführen können. Sie laden also Daten automatisch aus einer Quelle, formen sie um und legen sie am Ziel ab.
Ein Nachteil dieses Wegs: Der in Prozeduren gespeicherte Code kann schwer lesbar sein und verlangt eigene Werkzeuge für die Analyse. Diese Werkzeuge erlauben uns, den Code der Prozedur zu parsen und herauszufinden, welche Daten sie verarbeitet, woher sie sie lädt und wo sie sie ablegt. Mit anderen Worten: Wir müssen die Logik dessen, was die Prozedur tut, aus der Analyse ihres Codes selbst „erzeugen“.
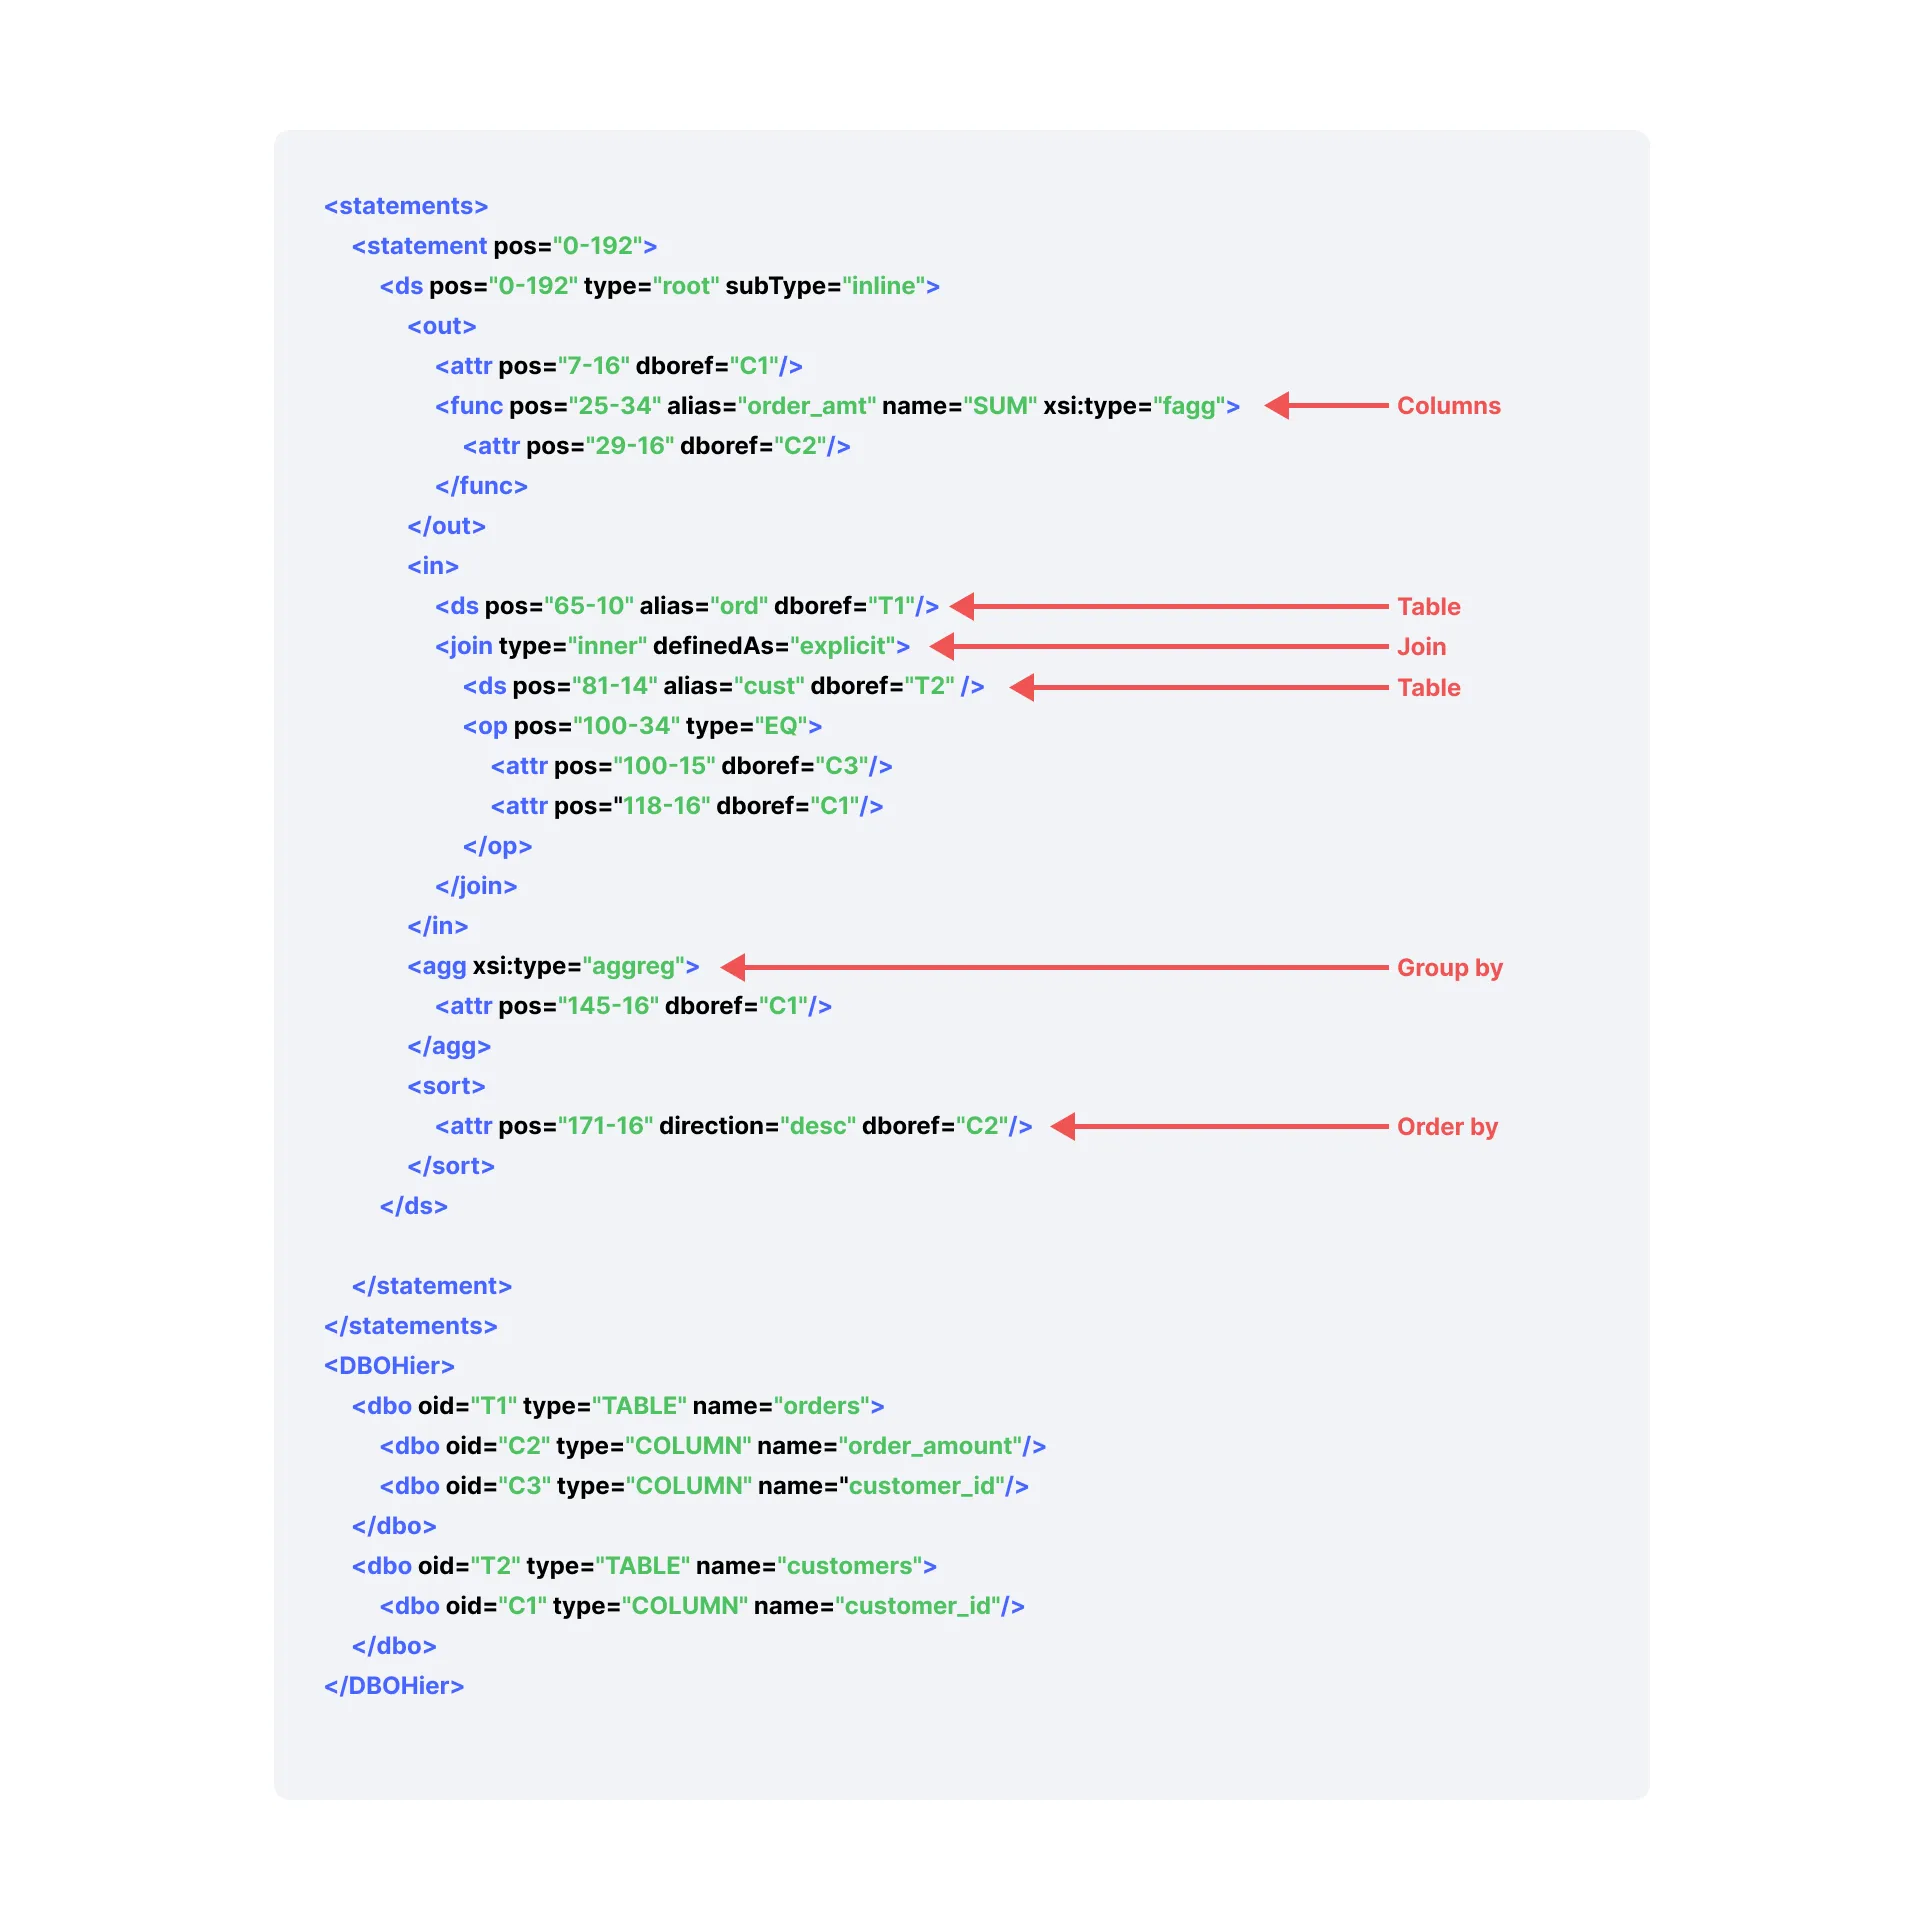
Parsing im Text ist ein Vorgang, bei dem strukturierter Text oder strukturierte Daten in kleinere, handlichere Teile zerlegt werden. Es ist, als zerlegte man einen Satz in einzelne Wörter oder Wendungen, um seinen Sinn besser zu fassen. Code-Parsing im Datenkontext richtet sich darauf, Angaben unmittelbar aus dem Quellcode zu analysieren und herauszuziehen.
Die Analyse des Codes untersucht Skripte und Quelltext, um Umformungen zu erkennen. Durch das Durchsehen von SQL-Skripten, Python-Code oder anderen Programmiersprachen lassen sich Angaben zur Lineage direkt aus der Codebasis gewinnen. Dieser Weg kann jedoch aufwendig sein, weil die Logik des Codes komplex ist, etwa bei dynamischem SQL und gespeicherten Prozeduren.
Dawiso bietet auf Wunsch Parser von Dritten für SQL-Code an. Diese Parser unterstützen SQL Server, Snowflake, Oracle und BigQuery. Es kann allerdings Grenzen bei der Zahl der verarbeiteten Zeilen oder Skripte geben. Der Einsatz dieser Parser verlangt eine Prüfung und Abstimmung mit dem Team von Dawiso. Kunden können auch eigene Parser mitbringen oder eigene Lösungen für ihren Bedarf entwickeln.
4. Manuelle Zuordnung der Daten
Die vierte Möglichkeit ist, dass die Logik der Umformung nirgends ausdrücklich festgehalten ist oder sich aus den vorhandenen Quellen nicht ziehen lässt. In diesem Fall müssten wir diese Logik von Hand finden, etwa indem wir die Dokumentation durchgehen, Fachleute befragen oder Aufbau und Inhalt einzelner Tabellen untersuchen.
Dieser Weg ist nur bei vergleichsweise wenigen Tabellen praktikabel. Wächst die Zahl der Tabellen deutlich, wird die Analyse von Hand sehr zeitaufwendig und fehleranfällig. Dann ist es fast unmöglich, ein vollständiges und richtiges Bild aller Umformungen zu bekommen.
Trotzdem ist die manuelle Zuordnung der Data Lineage in manchen Fällen nötig. Dabei werden die Angaben zur Lineage von Menschen angelegt und gepflegt. Das kostet Zeit, ist aber bei Altsystemen oder dort, wo automatische Wege nicht gangbar sind, oft unumgänglich.
Warum Data Lineage wichtig ist
- Schnellere Auswirkungsanalysen.
- Vertrauen in Daten: sichert Datenqualität und Richtigkeit.
- Fehler beseitigen: erlaubt leichtes Aufspüren und Beheben von Fehlern.
- Prüfung: liefert den Nachweis, welche Daten in eine bestimmte Auswertung eingegangen sind.
- Datenmanagement: erlaubt effizientes Verwalten und Pflegen des Data Warehouse.
Mit Data Lineage lässt sich jederzeit feststellen, woher die Daten in unserem Data Warehouse kommen, welche Änderungen an ihnen vorgenommen wurden und mit welchen Werkzeugen. Das ist unerlässlich für die Datenintegrität und für Entscheidungen, die sich auf Daten stützen.
Data Lineage in Dawiso
Dawiso begegnet den Schwierigkeiten der Data Lineage, indem es mehrere Wege der Extraktion verbindet. Unsere Plattform nutzt die Anbindung an ETL-Werkzeuge, die Analyse von Code und die manuelle Zuordnung und liefert so ein umfassendes Bild der Data Lineage. Zu den wichtigsten Funktionen von Dawiso gehören:
- Unterstützung verschiedener Datenquellen
- Anschauliche Lineage-Graphen zum leichten Erfassen
- Auswirkungsanalyse, um die Auswirkungen von Änderungen an Daten einzuschätzen
Data Lineage ist unerlässlich für Unternehmen, die die Wirkung ihrer Daten verstehen und Vorgaben einhalten wollen. Wer die Schwierigkeiten angeht und die passenden Wege nutzt, kann eine belastbare Praxis der Data Lineage aufbauen. Dawiso bietet dafür eine leistungsfähige Plattform, mit der Sie über eine umfassende Steuerung der Lineage das volle Potenzial Ihrer Daten heben.